#Del experimento al servicio
En un script breve, salir del proceso oculta muchos problemas de propiedad. En un servicio que vive días, cada tarea olvidada puede seguir consumiendo memoria, cada conexión sin cerrar reduce capacidad y cada reintento sin límite aumenta la carga cuando el destino ya está fallando.
Diseña tres ámbitos: servicio, lote o petición, y operación individual. El servicio posee clientes y recursos duraderos. Cada lote posee sus workers y productor. Cada operación posee la respuesta de streaming que está usando. El dueño cierra sus recursos cuando finaliza su ámbito.
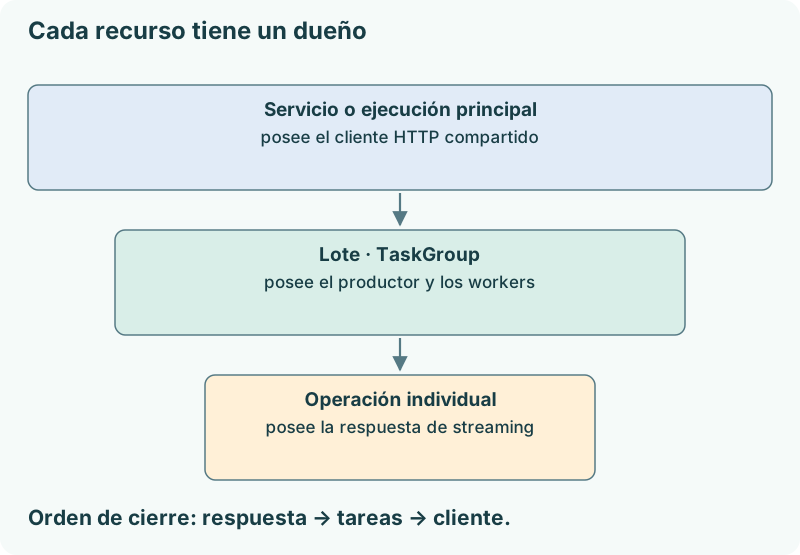
Esta estructura ayuda a responder «¿qué debo cancelar?» sin recorrer todas las tareas del proceso y adivinar cuáles son tuyas.
#Un fallo esperado no es un defecto del programa
Que un endpoint devuelva 503 es una situación del dominio del comprobador. Que tu código use una variable inexistente es un defecto. Convierte el primero en un resultado con estado y contexto; deja visible el segundo para que el dueño del lote detenga el grupo y registre el error.
Capturar Exception alrededor de cada worker y seguir indefinidamente puede dejar al servicio funcionando con un error sistemático. Si todos los trabajos reciben «error desconocido», la disponibilidad aparente no aporta valor. Define qué tipos son recuperables y qué evidencia obliga a detener la operación.
#Reintentos con motivo y presupuesto
Reintentar una consulta de lectura tras una indisponibilidad breve puede ser útil. Reintentar una contraseña incorrecta no. Repetir una escritura cuyo resultado es incierto puede duplicar efectos si el receptor no ofrece idempotencia.
Una política razonada tiene cinco piezas: errores elegibles, máximo de intentos, separación entre ellos, plazo total y una identidad estable cuando hay efectos. Cada reintento vuelve a consumir tasa y capacidad. Si aplicas reintentos en cliente, servicio y gateway, sus cantidades pueden multiplicarse.
import asyncio
import random


class Temporal(Exception):
    pass


async def con_reintentos(operacion, deadline):
    async with asyncio.timeout_at(deadline):
        for intento in range(3):
            try:
                return await operacion()
            except Temporal:
                if intento == 2:
                    raise
                techo = 0.1 * 2 ** intento
                await asyncio.sleep(random.uniform(0, techo))
Este fragmento usa una operación suministrada por el llamador y una excepción propia para enseñar la política, no para ocultar cualquier error. El backoff aumenta el techo entre intentos. El jitter elige una separación aleatoria dentro de ese techo para reducir la sincronización entre clientes que fallaron a la vez. El deadline exterior incluye las pausas; no se reinicia por intento.
Si el servidor envía Retry-After, interpreta su formato y comprueba que cabe en el presupuesto. Puede expresar segundos o una fecha HTTP. Si no puedes esperar lo que exige, devuelve un resultado pendiente o fallido en vez de reintentar inmediatamente. El proyecto final no añade reintentos: nos permite comprobar exactamente cuántas peticiones produjo cada entrada. Aquí queda explicado cómo incorporarlos sin cambiar las garantías por accidente.
#Parada ordenada frente a abandono
Una parada ordenada suele dejar de admitir entradas, permitir terminar lo ya aceptado durante un plazo y cancelar lo que siga pendiente al agotarlo. Después espera la limpieza de las tareas y cierra clientes. Cerrar el cliente antes de detener sus workers produce errores evitables: seguirán intentando usar un recurso ya cerrado.
Para una aplicación de consola, Ctrl+C llega a asyncio.run y solicita cancelar la tarea principal; los ámbitos hijos deben propagar esa cancelación y limpiar. En un servicio supervisado, el entorno suele enviar una señal de terminación. El punto de entrada debe traducirla a una petición de parada según el servidor y el sistema operativo utilizados.
Un evento de parada no despierta mágicamente a un worker bloqueado en queue.get(). Necesitas centinelas, una cancelación administrada o una espera diseñada para responder a ambas condiciones. En Python 3.12 empleamos centinelas para el fin normal y cancelación del dueño para la interrupción.
#Qué se pierde al caer el proceso
Una cola asyncio.Queue vive en memoria. Al caer el proceso, desaparecen sus elementos y los resultados no guardados. Que task_done() se haya ejecutado no demuestra durabilidad ni significa que un servicio remoto confirmó el efecto.
Para trabajos que deben sobrevivir, usa un almacén persistente con estados, reclamación y reintentos recuperables. Los detalles de colas y Streams de Redis y checkpoints amplían esa frontera. El núcleo asíncrono sigue siendo útil para procesar trabajo reclamado, pero no sustituye la garantía del almacenamiento.
En nuestro comprobador no hay efectos de negocio y el lote se puede repetir. Guardaremos un resumen en JSON al terminar. Esa decisión acepta perder resultados en una caída abrupta y evita fingir que una herramienta de laboratorio es un sistema de monitorización durable.
#Métricas que cambian decisiones
Mide al menos entrada admitida, longitud de cola, operaciones activas, resultados por estado y tiempos de cola y de operación. La latencia total puede empeorar aunque el tiempo de red no cambie: quizá estás esperando demasiado antes de empezar.
| Observación | Hipótesis que merece comprobarse |
|---|---|
| Cola llena, CPU baja, red lenta | El destino o tu límite de concurrencia restringen el caudal |
| Cola llena, CPU alta, retraso del bucle | Transformación pesada o llamadas bloqueantes |
PoolTimeout con pocos workers |
Respuestas sin cerrar o pool mal configurado |
| Muchos timeouts y muchos reintentos | Amplificación de una caída o presupuesto mal dimensionado |
| Memoria crece con cada lote | Resultados, referencias o tareas conservados sin límite |
No conviertas identificadores de usuario o URL completa en etiquetas de métricas: pueden tener cardinalidad enorme y contener secretos. Guarda un identificador de trabajo para relacionar logs, y registra destinos mediante nombres controlados. Una URL puede incluir tokens en su query string.
#Detectar que el bucle llega tarde
Una pausa programada permite estimar retraso del event loop. Si pides despertar en 100 milisegundos y reanudas 400 después, existe demora de coordinación. No demuestra por sí sola su causa, pero dirige la investigación.
import asyncio
import time


async def medir():
    loop = asyncio.get_running_loop()
    objetivo = loop.time() + 0.05
    await asyncio.sleep(0.05)
    retraso = max(0.0, loop.time() - objetivo)
    print("Retraso del bucle:", round(retraso, 3))
    assert retraso >= 0.05


async def main():
    tarea = asyncio.create_task(medir())
    await asyncio.sleep(0.01)
    time.sleep(0.15)  # Bloqueo deliberado para la prueba.
    await tarea


asyncio.run(main(), debug=True)
El modo debug también ayuda a localizar callbacks lentos y corrutinas que nunca se esperaron. En un servicio real mide con moderación y no escribas logs de red síncronos desde el bucle: el observador podría ser el bloqueo que intentas investigar.
#Una estrategia de pruebas pequeña y útil
Prueba invariantes separadas. Las pruebas de clasificación pueden usar un transporte simulado, pero una prueba de pooling necesita conexiones reales. Las pruebas de cancelación necesitan esperar la limpieza. Las de capacidad deben registrar picos con muchas más entradas que workers.
Evita afirmar «no hay fugas» solo porque una ejecución terminó. Comprueba que el cliente cerró, los contadores activos volvieron a cero y las tareas creadas por la operación finalizaron. Para un servicio duradero añade repetición de lotes y observación de memoria, descriptores y conexiones bajo carga representativa.
En las tres páginas siguientes construiremos un laboratorio pequeño con HTTP real para que estas garantías se vean en resultados y no se queden en recomendaciones.
#Referencias
- Desarrollo y diagnóstico con asyncio, Python 3.12.
- Runner e interrupción de teclado, Python 3.12.
- Semántica de Retry-After, RFC 9110.