#Antes de escribir async
Imagina que debes consultar el precio y el inventario de un producto. Ambas consultas son independientes: ninguna necesita el resultado de la otra. Si cada servidor tarda 200 milisegundos, hacerlas una detrás de otra acumula unos 400 milisegundos. Si las envías antes de esperar sus respuestas, buena parte de las dos esperas puede transcurrir durante los mismos 200 milisegundos.
La CPU no hizo dos veces más operaciones por segundo. Se evitó dejar una solicitud sin empezar mientras la otra estaba pendiente. Esta distinción impide un error frecuente: esperar que convertir un cálculo en async def lo haga más rápido.
#Concurrencia y paralelismo
La concurrencia organiza varias operaciones para que progresen durante un mismo intervalo. Pueden turnarse en un único hilo. El paralelismo ejecuta trabajo simultáneamente, por ejemplo en dos núcleos. Puedes tener cientos de solicitudes concurrentes y una sola tarea ejecutando instrucciones de Python en cada instante.
La asincronía permite representar una operación cuyo resultado aún no está disponible y reanudar su continuación después. asyncio es la biblioteca estándar de Python que organiza corrutinas, tareas y esperas bajo este modelo. No todas las bibliotecas de red tienen una interfaz compatible; una función síncrona sigue siendo síncrona aunque la llames dentro de una corrutina.
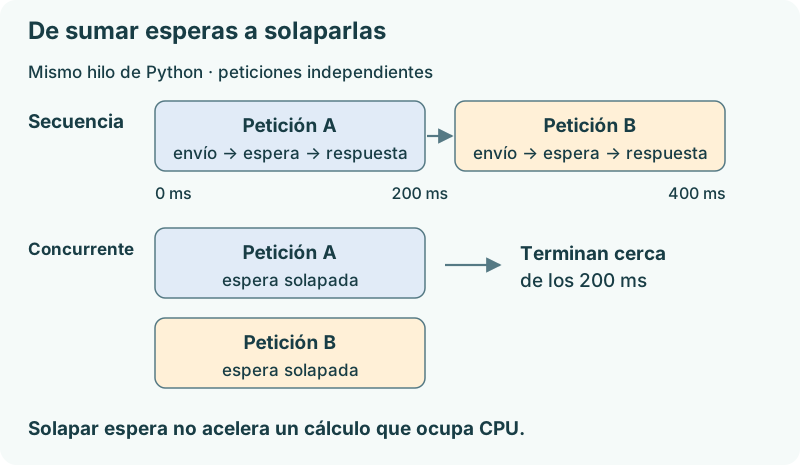
Los rectángulos de ejecución son pequeños, pero no tienen coste cero. Si cada respuesta exige un segundo de CPU para procesarla, solapar la red no elimina esos dos segundos de cálculo.
#Un experimento que puedes predecir
asyncio.sleep() representa aquí una espera simulada, no una petición de red. Su ventaja didáctica es que controlamos la duración. perf_counter() ofrece un reloj apropiado para medir intervalos; no usamos la hora del calendario porque puede ajustarse durante la medición.
import asyncio
from time import perf_counter


async def consultar(nombre):
    await asyncio.sleep(0.2)
    return f"datos de {nombre}"


async def main():
    inicio = perf_counter()
    precio = await consultar("precio")
    inventario = await consultar("inventario")
    print("Secuencia:", precio, inventario, round(perf_counter() - inicio, 2))

    inicio = perf_counter()
    precio, inventario = await asyncio.gather(
        consultar("precio"), consultar("inventario")
    )
    print("Concurrencia:", precio, inventario, round(perf_counter() - inicio, 2))


asyncio.run(main())
La primera medición rondará 0,4 segundos y la segunda 0,2. No son valores exactos: el sistema operativo y la carga afectan al momento en que se reanuda cada tarea. gather programa las operaciones juntas y recoge sus resultados; conoceremos sus reglas ante fallos en el tercer capítulo.
En las dos líneas con await, el orden del programa sigue importando. La segunda llamada de la secuencia no existe todavía cuando empieza la primera. await no significa «haz esto en segundo plano y sigue»: significa «necesito este resultado para continuar esta corrutina».
#Entrada y salida frente a CPU
Un trabajo limitado por I/O pasa gran parte del tiempo esperando datos: red, base de datos o disco. Un trabajo limitado por CPU pasa gran parte ejecutando instrucciones: transformar una imagen, comprimir un archivo o recorrer millones de registros.
| Trabajo | Qué suele ayudar | Qué no resuelve el problema |
|---|---|---|
| Varias peticiones HTTP independientes | Cliente asíncrono y concurrencia limitada | Añadir tareas sin controlar el servicio remoto |
| Una consulta lenta por falta de índice | Revisar la consulta y el índice | Lanzar cien consultas iguales |
| Calcular una transformación costosa | Mejor algoritmo, biblioteca nativa o procesos | Declarar la función con async def |
| Llamar a una biblioteca síncrona de I/O | Un hilo controlado o cambiar a API asíncrona | Colocarla dentro del event loop sin adaptación |
Un archivo local también es I/O, pero no toda operación de disco dispone de una API asíncrona en la biblioteca estándar. No se decide la estrategia únicamente por el nombre del recurso: hay que mirar cómo se comporta la llamada concreta.
#Por qué una pausa puede bloquearlo todo
El bucle de eventos utiliza cooperación. Una tarea deja avanzar a las demás cuando se suspende o termina. Si ejecuta código síncrono largo, conserva el hilo. El siguiente ejemplo introduce deliberadamente ese defecto:
import asyncio
import time


async def pulso():
    for numero in range(4):
        print("pulso", numero)
        await asyncio.sleep(0.05)


async def bloqueo():
    await asyncio.sleep(0.02)
    print("empieza bloqueo")
    time.sleep(0.2)  # Defecto intencionado: ocupa el hilo del bucle.
    print("termina bloqueo")


async def main():
    await asyncio.gather(pulso(), bloqueo())


asyncio.run(main())
Entre «empieza bloqueo» y «termina bloqueo» no aparece ningún pulso. Cambia esa línea por await asyncio.sleep(0.2): los pulsos pueden progresar durante la espera. El mismo problema aparece con requests.get, una consulta síncrona a la base o un bucle de CPU pesado.
Esto también retrasa los timeouts. El bucle no puede disparar una cancelación mientras la única tarea que ocupa su hilo se niega a devolver el control. Un plazo asíncrono no es una interrupción física del procesador.
#Las dependencias siguen imponiendo secuencia
Si necesitas obtener un token antes de consultar datos privados, el segundo paso depende del primero. Debes esperar el token. Después quizá puedas consultar perfil y facturas en paralelo usando ese mismo token.
Dibuja primero las dependencias: A → B y A → C. Solo B y C pueden solaparse. Lanzar C antes de tener sus requisitos no es una optimización; es un error de diseño. En procesos de negocio, una segunda operación también puede depender de que la primera se haya confirmado, no solo de conocer un valor.
#Cuánta mejora es razonable esperar
Con cuatro operaciones independientes de latencias 0,1; 0,2; 0,3 y 0,4 segundos, la secuencia ronda un segundo. Sin otros límites, el conjunto concurrente ronda la operación más lenta: 0,4. Si impones dos operaciones simultáneas, el reparto y el orden cambian el tiempo total.
Añadir concurrencia puede empeorar la latencia si satura conexiones, CPU, memoria o el servicio remoto. Primero mide el tiempo y la cantidad de trabajo; después incrementa el límite poco a poco. «Más tareas» no es un objetivo técnico.
#Comprueba tu modelo mental
Explica qué cambia si consultar hace un cálculo de 200 milisegundos sin ningún await: ambas versiones ocupan el mismo hilo durante aproximadamente 400 milisegundos de cálculo. A continuación añade una dependencia entre precio e inventario y decide qué parte puede seguir siendo concurrente.
En el siguiente capítulo separaremos tres objetos que suelen confundirse: la función corrutina, una ejecución de esa función y la tarea que la administra.