#Cuatro límites que no son intercambiables
Un límite de concurrencia controla cuántas operaciones están dentro de una actividad al mismo tiempo. Un límite de tasa controla con qué frecuencia empiezan. Un pool limita recursos reutilizables, como conexiones. Una cola acotada limita entradas pendientes y puede frenar al productor cuando se llena.
Ejemplo: tres workers pueden mantener tres consultas simultáneas, pero si cada una tarda 10 milisegundos podrían iniciar unas 300 por segundo. Un servicio que permite veinte solicitudes por segundo necesita además limitar la tasa. Si creaste un millón de tareas para que esperen a esos workers, la memoria ya ha recibido el millón de objetos.
#Lo que protege un semáforo
asyncio.Semaphore(3) administra tres permisos compartidos. Al entrar mediante async with, una tarea espera un permiso; al salir lo devuelve, incluso ante una excepción. El permiso debe abarcar toda la operación que quieres contar, incluida su espera de red.
# Fragmento: todas las llamadas reciben la misma instancia de limite.
async def consultar_limitado(cliente, url, limite):
    async with limite:
        return await cliente.get(url)
Crear Semaphore(3) dentro de cada llamada concede tres permisos distintos a cada operación: no hay límite común. Crear cien mil tareas con esta función sí limita cuántas entran a HTTP, pero no cuántas tareas existen esperando.
Cuando el conjunto es pequeño y ya acotado, un semáforo es cómodo. Cuando la entrada puede crecer mucho, usa un número fijo de consumidores y limita lo que espera antes de ellos.
#Backpressure significa que el productor también espera
La contrapresión, o backpressure, hace que un consumidor saturado frene a quien le entrega trabajo. En asyncio.Queue(maxsize=6), await queue.put(elemento) espera si hay seis elementos pendientes. Ese await es la pieza que devuelve la presión al productor; una lista sin límite no tiene ese mecanismo.
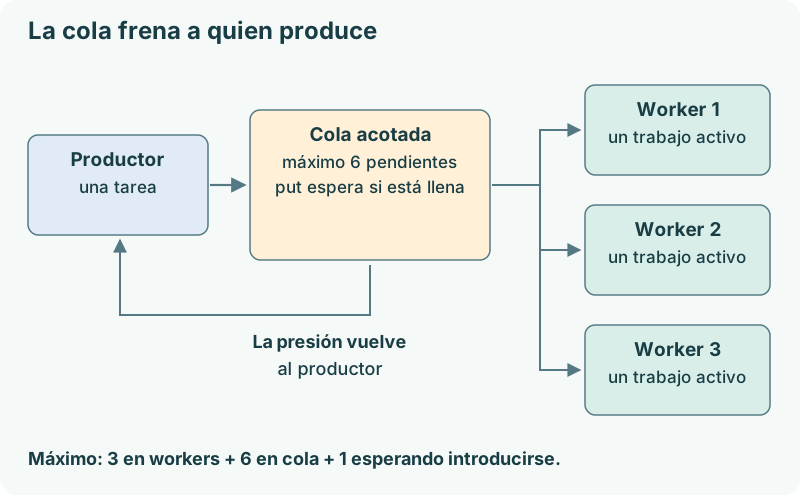
Una cola de seis elementos puede contener seis referencias enormes. También debes limitar el tamaño de cada entrada y del resultado. Si guardas todos los resultados sin límite, solo moviste el crecimiento a otra lista.
#Un lote acotado y ejecutable
Este ejemplo procesa mil números con tres workers y una cola de seis. Las mil entradas se generan de una en una mediante range; no se crean mil tareas. None es una señal de fin, llamada centinela, porque nunca es un elemento válido en esta práctica.
import asyncio


async def main():
    cola = asyncio.Queue(maxsize=6)
    activos = 0
    pico_activos = 0
    pico_cola = 0
    terminados = 0

    async def producir():
        nonlocal pico_cola
        for numero in range(1000):
            await cola.put(numero)
            pico_cola = max(pico_cola, cola.qsize())
        for _ in range(3):
            await cola.put(None)

    async def consumir():
        nonlocal activos, pico_activos, terminados
        while True:
            numero = await cola.get()
            try:
                if numero is None:
                    return
                activos += 1
                pico_activos = max(pico_activos, activos)
                try:
                    await asyncio.sleep(0.001)
                    terminados += 1
                finally:
                    activos -= 1
            finally:
                cola.task_done()

    async with asyncio.TaskGroup() as grupo:
        grupo.create_task(producir())
        for _ in range(3):
            grupo.create_task(consumir())
    await cola.join()
    assert terminados == 1000 and activos == 0
    assert pico_activos <= 3 and pico_cola <= 6
    print(terminados, pico_activos, pico_cola)


asyncio.run(main())
nonlocal permite actualizar las variables del ámbito exterior desde estas funciones anidadas; no introduce un dato global compartido por todos los programas. Las mediciones se actualizan sin suspenderse entre leer y escribir, en el mismo hilo del bucle.
get retira un elemento. task_done informa de que ese elemento terminó su recorrido en la cola; no significa necesariamente que el trabajo de negocio tuvo éxito. join espera hasta que todos los elementos introducidos recibieron su task_done. Debe existir exactamente una llamada por cada get que tuvo éxito, incluso para el centinela. Por eso está en finally.
Los centinelas entran después de los datos y en número igual al de workers. La cola FIFO garantiza que no adelantan a entradas anteriores. Al salir del grupo sabemos que productor y consumidores terminaron; join comprueba además que no olvidamos el registro de finalización.
#La cota real del trabajo admitido
Con tres workers, cola de seis y un productor, puede haber hasta tres elementos en ejecución, seis esperando y uno que el productor ya obtuvo de la fuente mientras espera introducirlo. Ese último elemento importa cuando contiene muchos bytes.
La fuente también debe tener un contrato: un generador que lee un archivo completo internamente no hace memoria acotada por el hecho de usar yield. Si la lectura puede bloquear, adáptala; si admite entradas ilimitadas, define dónde persistes o descartas los resultados. En el proyecto limitaremos además el lote a mil registros y el tamaño de cada ruta.
Si un worker falla inesperadamente, TaskGroup cancela productor y demás workers. En esa salida de error puede quedar contenido en la cola; no debes hacer un join() infinito fingiendo que los workers seguirán procesándolo. La cola en memoria se descarta con el lote fallido y el error se comunica.
#Limitar la tasa de inicio
Para una sola instancia del programa, un ritmo mínimo entre inicios puede implementarse con un reloj monotónico. Este mecanismo no permite ráfagas y comparte un lock entre participantes. La espera dentro del lock es intencional: impide que dos tareas ocupen el mismo turno.
import asyncio


class Ritmo:
    def __init__(self, por_segundo):
        if por_segundo <= 0:
            raise ValueError("la tasa debe ser positiva")
        self.intervalo = 1 / por_segundo
        self.siguiente = 0.0
        self.lock = asyncio.Lock()

    async def esperar(self):
        async with self.lock:
            loop = asyncio.get_running_loop()
            demora = self.siguiente - loop.time()
            if demora > 0:
                await asyncio.sleep(demora)
            self.siguiente = loop.time() + self.intervalo
El llamador hace await ritmo.esperar() inmediatamente antes de iniciar cada intento. Se calcula el siguiente turno desde el instante efectivo, no desde una fecha vencida: si el bucle se retrasó, no libera muchos turnos juntos para «recuperar» el tiempo.
La política limita inicios locales, no asegura los instantes exactos de llegada al servidor. Tampoco es una cuota global entre varios procesos. Si el proveedor mide por cuenta y ejecutas diez instancias, sus presupuestos deben coordinarse o repartirse. Para cuotas con ráfagas existen diseños de cubeta de tokens; no son necesarios para este primer cliente sin ráfagas.
#Esperar una cola también consume presupuesto
Si una solicitud ya lleva un segundo esperando y su plazo total es de 1,2 segundos, darle otros 1,2 al empezar el worker viola el contrato. Guarda la hora de admisión y calcula el deadline a partir de ella. Rechaza trabajo ya vencido sin enviarlo al servicio remoto.
Si la cola permanece llena y la latencia crece, aumentar su tamaño compra tiempo hasta agotar más memoria; no aumenta capacidad. Las opciones reales son reducir entrada, acelerar consumidores, subir capacidad bajo medición o rechazar trabajo con una respuesta clara.
#Comprueba los límites, no solo la velocidad
En el programa de mil números, aumenta la demora del consumidor y observa que la cola llega a seis mientras los activos no superan tres. Aumentar entradas a diez mil alarga el tiempo, pero no crea diez mil tareas. Quita maxsize y verás que desaparece la garantía sobre pendientes.
Prueba a lanzar un error dentro de un consumidor: el grupo debe salir con error y no quedarse esperando para siempre en join. El siguiente capítulo explica cuándo estas tareas necesitan protección adicional al compartir datos.
#Referencias
- Queues, Python 3.12: capacidad,
task_doneyjoin. - Semáforos y locks, Python 3.12.