#Una herramienta pequeña con garantías visibles
Vamos a construir un investigador documental que recibe una pregunta, busca documentos autorizados, lee evidencia y guarda un borrador con referencias. Su objetivo verificable es reunir evidencia en un informe recuperable, no certificar automáticamente que cualquier diagnóstico sea verdadero. La revisión de sus afirmaciones sigue formando parte del uso del informe.
El miniproyecto ocupa tres páginas: aquí defines datos y herramientas; después conectas el modelo y el runtime; finalmente provocas caídas y verificas recuperación. Todo el código necesario está dentro de estas páginas. Si quieres ejecutarlo, crea un archivo local llamado agente.py y añade los bloques marcados «Código del programa» en su orden. No necesitas descargar un proyecto ni salir a un repositorio.
Para la versión determinista basta Python 3.12 o posterior con sqlite3. Usa una carpeta vacía: la ejecución creará agente.db allí. El adaptador opcional requiere un servidor Ollama local y un modelo compatible; puedes estudiar y probar toda la persistencia sin instalarlo.
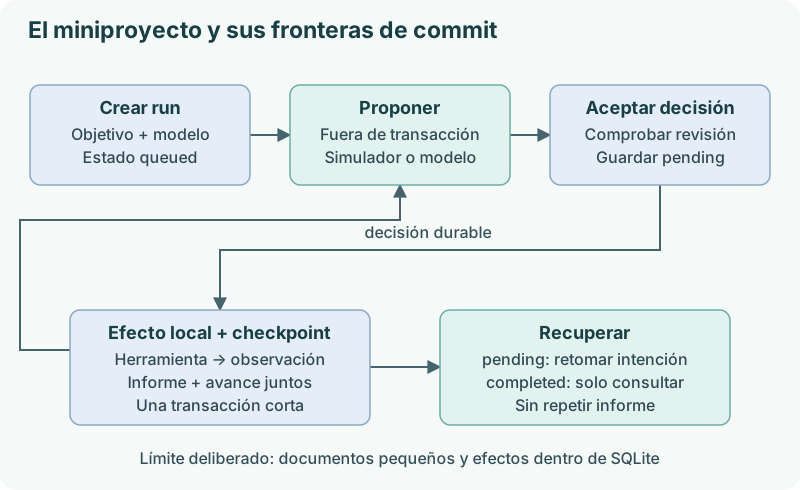
Las herramientas del proyecto solo leen un catálogo en memoria o escriben en la misma base de datos. Esta decisión permite unir el informe y el checkpoint en una transacción. Las llamadas a servicios externos exigen la reconciliación explicada en el curso.
#Fase 1 · Fijar el ámbito antes de dar herramientas
El catálogo DOCS representa tres documentos de un workspace autorizado. Es deliberadamente pequeño para que puedas comprobar cada resultado. En una aplicación con usuarios, el servidor construiría este conjunto a partir de la identidad autenticada; el modelo no elegiría su tenant.
TOOLS describe contratos, pero no contiene funciones ejecutables. El modelo puede proponer search, read o report; el ejecutor las implementará. Mantener esas dos piezas separadas permite revisar qué promete una herramienta y qué hace realmente.
La función encode produce JSON estable con claves ordenadas. digest identifica contenido con SHA-256. Las importaciones pertenecen a la biblioteca estándar: re divide palabras, os consulta configuración, sys lee argumentos del comando y urllib.request se usará solo para el adaptador HTTP opcional.
Código del programa · bloque 1.
import hashlib
import json
import os
import re
import sqlite3
import sys
from contextlib import contextmanager
from urllib.request import Request, urlopen

DOCS = {
    "red": "La API conecta a db:5432 dentro de la red interna. El puerto 5433 es solo del host.",
    "incidente": "El registro de api muestra connection refused db:5433. La base escucha en 5432.",
    "cache": "La cache Redis contiene datos temporales y no almacena la base principal.",
}
TOOLS = {
    "search": "args: {query: texto}. Busca documentos autorizados y devuelve identificadores.",
    "read": "args: {id: texto}. Lee uno de los documentos autorizados completos.",
    "report": "args: {answer: texto, sources: [id]}. Guarda un borrador con documentos ya leídos.",
}


def encode(value):
    return json.dumps(value, ensure_ascii=False, sort_keys=True)


def digest(text):
    return hashlib.sha256(text.encode("utf-8")).hexdigest()
El documento de red explica una regla y el de incidencia aporta una observación. El informe debe conservar ambos para razonar que el puerto usado por la API no coincide con el listener interno. El tercer documento permite observar que recuperar por coincidencias puede traer contenido menos útil; no todas las coincidencias son evidencia de la causa.
#Fase 2 · Una frontera transaccional explícita
Una transacción corta agrupará efecto interno, observación y avance. El decorador @contextmanager convierte una función con yield en un bloque with: el código previo al yield abre la transacción; el cuerpo del with realiza las escrituras; al terminar vuelve a COMMIT; si el cuerpo lanza una excepción, esa excepción se recibe en el yield y pasa al rollback.
Código del programa · bloque 2.
@contextmanager
def transaction(db):
    db.execute("BEGIN IMMEDIATE")
    try:
        yield
        db.execute("COMMIT")
    except BaseException:
        if db.in_transaction:
            db.execute("ROLLBACK")
        raise
No llamaremos al modelo dentro de esta transacción. Una inferencia lenta no debe mantener reservada la escritura de SQLite. La posterior aceptación de la decisión comprobará una versión para detectar si el estado cambió mientras esperábamos.
#Fase 3 · Guardar lo necesario para continuar
runs guarda objetivo, ruta de modelo, estado, límites consumidos y decisión pendiente. operations conserva cada decisión ya ejecutada y su observación. reports impone un informe por ejecución mediante su clave primaria. events sirve para inspeccionar el progreso durable.
revision detecta propuestas calculadas sobre un estado obsoleto. step cuenta acciones confirmadas y requests cuenta intentos de inferencia admitidos, incluso si el proceso cae antes de guardar su respuesta. Esto evita que reiniciar restablezca gratis los límites.
sqlite3.Row permite acceder a columnas por nombre en lugar de recordar posiciones. executescript crea el esquema al abrir la aplicación; es aceptable para este laboratorio. En un servicio que evoluciona usarías migraciones versionadas, no confiarías en IF NOT EXISTS para transformar tablas existentes.
Código del programa · bloque 3.
def connect():
    db = sqlite3.connect(os.environ.get("AGENT_DB", "agente.db"),
                         autocommit=True, timeout=5)
    db.row_factory = sqlite3.Row
    db.execute("PRAGMA foreign_keys=ON")
    db.executescript("""
        CREATE TABLE IF NOT EXISTS runs(
            id TEXT PRIMARY KEY, goal TEXT NOT NULL, model TEXT NOT NULL,
            status TEXT NOT NULL, step INTEGER NOT NULL DEFAULT 0,
            requests INTEGER NOT NULL DEFAULT 0, revision INTEGER NOT NULL DEFAULT 0,
            pending TEXT
        );
        CREATE TABLE IF NOT EXISTS operations(
            run_id TEXT REFERENCES runs(id), step INTEGER NOT NULL,
            decision TEXT NOT NULL, result TEXT NOT NULL,
            PRIMARY KEY(run_id, step)
        );
        CREATE TABLE IF NOT EXISTS reports(
            run_id TEXT PRIMARY KEY REFERENCES runs(id),
            answer TEXT NOT NULL, sources TEXT NOT NULL, content_hash TEXT NOT NULL
        );
        CREATE TABLE IF NOT EXISTS events(
            seq INTEGER PRIMARY KEY AUTOINCREMENT,
            run_id TEXT NOT NULL REFERENCES runs(id),
            kind TEXT NOT NULL, payload TEXT NOT NULL
        );
    """)
    return db


def event(db, run_id, kind, payload):
    db.execute("INSERT INTO events(run_id, kind, payload) VALUES (?, ?, ?)",
               (run_id, kind, encode(payload)))


def create(db, run_id, goal):
    with transaction(db):
        db.execute("INSERT INTO runs(id, goal, model, status) VALUES (?, ?, ?, ?)",
                   (run_id, goal, os.environ.get("OLLAMA_MODEL", "simulado"), "queued"))
        event(db, run_id, "created", {"goal": goal})


def history(db, run_id):
    rows = db.execute("SELECT decision, result FROM operations WHERE run_id=? ORDER BY step",
                      (run_id,)).fetchall()
    return [{"decision": json.loads(row["decision"]), "result": json.loads(row["result"])}
            for row in rows]
history reconstruye la trayectoria a partir de operaciones confirmadas. Una propuesta pendiente vive en runs.pending y todavía no aparece como resultado. Esa distinción permite reiniciar entre aceptar una decisión y ejecutarla.
Los estados de este programa pequeño son queued, running, completed, cancelled y budget_exhausted. completed significa «borrador guardado con fuentes leídas y versión comprobada». No significa «todas sus afirmaciones verificadas semánticamente». La arquitectura general puede normalizarlos en status y reason, como se explica en el capítulo de estado.
#Fase 4 · Validar antes de interpretar
La salida del modelo es un dato no confiable. Comprobamos claves, tipos, tamaños y nombres de acción. Para report exigimos fuentes no repetidas; después el ejecutor comprobará que realmente se leyeron. Una salida JSON válida todavía puede incumplir todo eso.
Código del programa · bloque 4.
def validate(decision):
    if not isinstance(decision, dict) or set(decision) != {"action", "args"}:
        raise ValueError("La decisión necesita action y args")
    action, args = decision["action"], decision["args"]
    if not isinstance(action, str) or action not in TOOLS or not isinstance(args, dict):
        raise ValueError("Acción o argumentos inválidos")
    expected = {"search": {"query"}, "read": {"id"}, "report": {"answer", "sources"}}
    if set(args) != expected[action]:
        raise ValueError("Claves de argumentos inválidas")
    key = {"search": "query", "read": "id", "report": "answer"}[action]
    limit = 6000 if action == "report" else 300
    if not isinstance(args[key], str) or not args[key].strip() or len(args[key]) > limit:
        raise ValueError("Texto vacío o demasiado largo")
    if action == "report":
        sources = args["sources"]
        if (not isinstance(sources, list) or not 1 <= len(sources) <= 3
                or any(not isinstance(item, str) for item in sources)
                or len(set(sources)) != len(sources)):
            raise ValueError("Fuentes inválidas")
    return decision
El validador también limita texto para evitar entradas desproporcionadas. El tamaño de la respuesta HTTP se limitará antes de parsearla. Son límites distintos: bytes recibidos, forma del objeto y significado de sus valores.
#Fase 5 · Herramientas que devuelven evidencia
search usa coincidencias de palabras y devuelve identificadores con score. read devuelve el texto y su hash. report solo acepta fuentes leídas cuya versión sigue siendo la actual y crea una fila de informe.
¿Por qué no permitir report con cualquier identificador existente? Porque citar una fuente no demuestra que el modelo haya visto su contenido. Exigir lectura elimina ese fallo concreto. No elimina una interpretación equivocada; el resultado sigue siendo un borrador.
Código del programa · bloque 5.
def execute(db, run_id, decision, past):
    action, args = decision["action"], decision["args"]
    if action == "search":
        wanted = set(re.findall(r"\w+", args["query"].casefold()))
        hits = [{"id": key, "score": len(wanted & set(re.findall(r"\w+", text.casefold())))}
                for key, text in DOCS.items()]
        return {"hits": sorted((hit for hit in hits if hit["score"]),
                               key=lambda hit: (-hit["score"], hit["id"]))[:3]}
    if action == "read":
        key = args["id"]
        if key not in DOCS:
            return {"error": "DOCUMENT_NOT_AVAILABLE"}
        return {"id": key, "text": DOCS[key], "hash": digest(DOCS[key])}
    read_versions = {item["result"]["id"]: item["result"]["hash"] for item in past
                     if item["decision"]["action"] == "read" and "id" in item["result"]}
    if any(key not in read_versions or key not in DOCS
           or read_versions[key] != digest(DOCS[key]) for key in args["sources"]):
        return {"error": "READ_CURRENT_SOURCES_FIRST"}
    content_hash = digest(encode(args))
    db.execute("INSERT INTO reports VALUES (?, ?, ?, ?)",
               (run_id, args["answer"], encode(args["sources"]), content_hash))
    return {"report_hash": content_hash, "sources": args["sources"]}
La herramienta devuelve errores de negocio como DOCUMENT_NOT_AVAILABLE en una observación para que el modelo pueda reaccionar. Una excepción inesperada del programa no se convierte en una observación aparentemente normal: aborta la transacción y conserva la decisión pendiente para diagnosticarla.
execute debe llamarse dentro de la transacción de avance que escribiremos a continuación. El INSERT del informe, el registro de operación y el cursor se confirmarán juntos. Esta garantía solo cubre efectos dentro de esta misma base. No añadas un envío de email aquí esperando que SQLite lo deshaga si hay rollback.
#Lo que ya puedes razonar
Si el proceso cae antes de crear el informe, no hay artefacto. Si cae después de su INSERT pero antes del commit, SQLite revierte ese cambio al recuperar. Si cae después del commit, tanto el informe como la observación y el avance existen. La siguiente página implementa esas fronteras.
#Referencias
- sqlite3, Python:
Row, parámetros, transacciones y persistencia. - contextlib, Python:
contextmanagery propagación de excepciones. - hashlib, Python: hash de contenido.