#La pestaña no debe ser dueña del trabajo
Una conexión HTTP puede cerrarse por navegación, red o timeout. Si su vida coincide con la de una tarea larga, el usuario no sabe si se canceló, sigue trabajando o perdió el resultado. La API debe guardar una intención y devolver un run_id; un worker avanza esa ejecución; el cliente consulta su estado.
Cola significa trabajo disponible. Worker significa proceso que lo reclama. Orquestador significa reglas para crear, reanudar, esperar, cancelar y finalizar. Puedes implementar las tres responsabilidades con una base de datos y un servicio pequeño. Un broker adicional se justifica por necesidades de capacidad o integración, no por el nombre «agente».
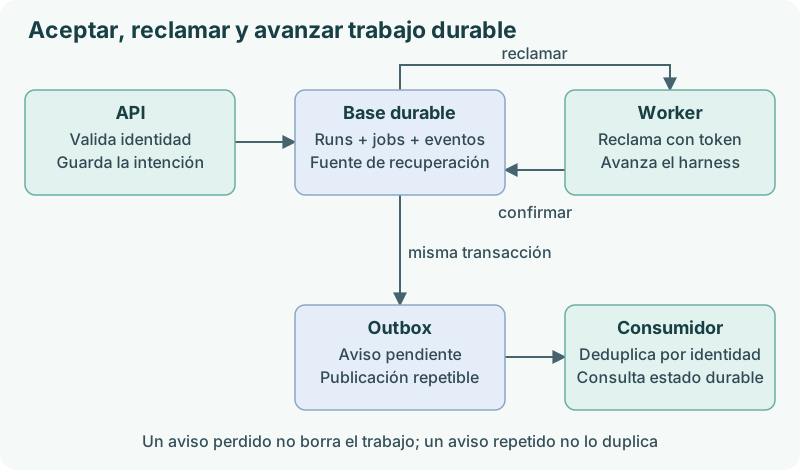
La base conserva intención y estado. Las notificaciones aceleran el descubrimiento; perder una notificación no debe borrar una tarea.
#Qué significa aceptar una solicitud
Una API debería confirmar aceptación después de guardar el objetivo y el trabajo pendiente en una transacción. Si devuelve éxito antes y el proceso cae, el usuario tiene un identificador de algo inexistente.
El cliente también puede repetir una petición cuyo resultado se perdió. Una clave de idempotencia de creación, única por usuario y solicitud, permite devolver el mismo run. Conserva un hash del cuerpo: la misma clave con otro objetivo debe rechazarse, no reinterpretarse.
-- Esquema conceptual: ambas escrituras se confirman juntas.
BEGIN;
INSERT INTO runs(id, owner_id, request_key, goal, status)
VALUES ('r-17', 'u-4', 'req-91', 'Analizar la incidencia', 'queued');
INSERT INTO jobs(run_id, available_at) VALUES ('r-17', CURRENT_TIMESTAMP);
COMMIT;
Aquí request_key necesita una restricción UNIQUE(owner_id, request_key). Los valores son ilustrativos; el código debe usar parámetros SQL y recuperar el run existente si la solicitud se repite con el mismo cuerpo.
#Reclamar trabajo de forma atómica
Leer «la primera tarea pendiente» y después marcarla como ocupada en dos operaciones independientes permite que dos workers la lean a la vez. La selección y la reclamación deben ocurrir dentro de una transacción con el bloqueo apropiado.
En SQLite puedes usar una transacción corta BEGIN IMMEDIATE, seleccionar una fila disponible y actualizar su propietario antes de confirmar. Esto serializa escritores; es sencillo para un servicio en una máquina. No mantengas esa transacción durante la ejecución.
En PostgreSQL, una estrategia de cola usa bloqueo de fila y SKIP LOCKED. Este ejemplo supone columnas id, status, available_at, lease_until, lease_token y worker_id en jobs:
WITH candidate AS (
    SELECT id
    FROM jobs
    WHERE available_at <= CURRENT_TIMESTAMP
      AND (status = 'queued'
           OR (status = 'running' AND lease_until < CURRENT_TIMESTAMP))
    ORDER BY available_at, id
    FOR UPDATE SKIP LOCKED
    LIMIT 1
)
UPDATE jobs AS job
SET status = 'running',
    worker_id = 'worker-2',
    lease_token = job.lease_token + 1,
    lease_until = CURRENT_TIMESTAMP + INTERVAL '30 seconds'
FROM candidate
WHERE job.id = candidate.id
RETURNING job.*;
WITH da un nombre a un resultado intermedio. FOR UPDATE bloquea la fila elegida hasta terminar la transacción. SKIP LOCKED permite que otro worker salte filas ocupadas. Es útil para consumidores de una cola, pero no ofrece una vista general consistente de todos los datos; no lo uses indiscriminadamente en consultas de negocio.
#Un lease no mata al antiguo worker
Un lease concede propiedad hasta una hora. El worker lo renueva periódicamente mediante un heartbeat. Si desaparece, otro puede reclamar al expirar. Pero el antiguo puede estar vivo, congelado por una pausa o una partición de red, y continuar después.
Un fencing token es un número creciente asociado a cada reclamación. Cada escritura debe demostrar que sigue perteneciendo al token actual:
UPDATE jobs
SET lease_until = CURRENT_TIMESTAMP + INTERVAL '30 seconds'
WHERE id = :job_id
  AND worker_id = :worker_id
  AND lease_token = :token
  AND status = 'running'
  AND lease_until > CURRENT_TIMESTAMP;
La notación :nombre representa parámetros de aplicación; el placeholder real depende del driver. Si se actualizan cero filas, el worker perdió autoridad y debe dejar de iniciar acciones. Las escrituras de estado y resultados deben aplicar una comprobación equivalente, dentro de la misma transacción.
Esto protege tu base de datos si la comprobación se aplica correctamente. No impide que el worker viejo envíe un correo desde una API que ignora ese token. Los efectos externos necesitan idempotencia, precondiciones o un ejecutor central que aplique la autoridad vigente.
#Un worker antiguo rechazado, paso a paso
Este ejemplo completo usa tiempo simulado para observar una expiración sin esperar. No pretende sincronizar relojes distribuidos: en un servicio real, el almacenamiento debe ser la referencia temporal coherente de reclamaciones y escrituras.
El worker A reclama hasta el instante 10. En el instante 11, B reclama con un token nuevo. A sigue vivo y trata de guardar un resultado tardío. El WHERE de la escritura lo rechaza porque su token ya no representa autoridad.
import sqlite3


db = sqlite3.connect(":memory:", autocommit=True)
db.executescript("""
    CREATE TABLE jobs(
        id TEXT PRIMARY KEY, worker TEXT, token INTEGER NOT NULL,
        lease_until INTEGER NOT NULL, status TEXT NOT NULL, result TEXT
    );
    INSERT INTO jobs VALUES ('j-1', NULL, 0, 0, 'queued', NULL);
""")


def claim(worker, now, duration=10):
    db.execute("BEGIN IMMEDIATE")
    try:
        changed = db.execute(
            "UPDATE jobs SET worker=?, token=token+1, lease_until=?, status='running' "
            "WHERE id='j-1' AND (status='queued' OR "
            "(status='running' AND lease_until<=?))",
            (worker, now + duration, now),
        ).rowcount
        token = db.execute("SELECT token FROM jobs WHERE id='j-1'").fetchone()[0]
        db.execute("COMMIT")
        return token if changed else None
    except BaseException:
        if db.in_transaction:
            db.execute("ROLLBACK")
        raise


def save(worker, token, now, result):
    changed = db.execute(
        "UPDATE jobs SET result=?, status='completed' "
        "WHERE id='j-1' AND worker=? AND token=? "
        "AND status='running' AND lease_until>?",
        (result, worker, token, now),
    ).rowcount
    return changed == 1


a = claim("A", now=0)
assert a == 1
assert claim("B", now=5) is None
b = claim("B", now=11)
assert b == 2
assert save("A", a, now=12, result="tardío") is False
assert save("B", b, now=12, result="vigente") is True
assert db.execute("SELECT result FROM jobs").fetchone()[0] == "vigente"
db.close()
print("A rechazado; solo B confirma con token 2")
La primera reclamación de B se rechaza porque el lease de A sigue vigente. La segunda tiene éxito. El resultado viejo nunca se confirma, aunque A no haya terminado. Esta es la propiedad que no proporciona un timeout por sí solo. Si A ya hubiera enviado una petición externa, este WHERE no podría retirarla: la siguiente lección aborda ese límite.
#El problema de guardar y publicar
Supón que guardas run=queued y después publicas un mensaje en un broker. Si caes entre ambos, el run queda olvidado. Si publicas primero, el consumidor puede recibir una tarea que aún no existe. Una outbox transaccional guarda el hecho a publicar en la misma transacción que el cambio de negocio.
CREATE TABLE outbox (
    event_id TEXT PRIMARY KEY,
    topic TEXT NOT NULL,
    payload TEXT NOT NULL,
    published_at TEXT
);
El productor guarda run y fila outbox juntos. Un publicador lee filas pendientes, envía al broker y marca su confirmación. Si cae después del envío pero antes de marcar, enviará otra vez. Por eso el consumidor debe deduplicar por event_id. La outbox ofrece una intención durable con entrega repetible, no una promesa de «exactamente una vez» de extremo a extremo.
Si tu worker consulta directamente la tabla de jobs, no necesitas un broker ni outbox solo para despertarlo. Un sondeo periódico puede bastar. Introduce la outbox cuando hay dos sistemas cuyo cambio no puede confirmarse en una única transacción local.
#Esperar sin ocupar un worker
Una ejecución que espera aprobación no debería mantener una conexión y un proceso bloqueados durante horas. Guarda estado waiting, causa y condición de reanudación. Cuando llega el dato, persiste su recepción y crea una nueva activación. El worker reconstruye el estado y continúa.
La activación es una señal, no la información en sí. Si se pierde, un reconciliador puede descubrir runs preparados para continuar. Si se duplica, reclamar con versión o token evita dos avances incompatibles.
#Capacidad y equidad
Más workers no solucionan una cuota de proveedor saturada. Limita concurrencia global, por modelo y por usuario. Una cola con muchos trabajos de un cliente puede bloquear al resto; una política de turnos por tenant o límites por propietario evita esa monopolización.
Observa edad del trabajo pendiente, duración del lease y tasa de expiración. Muchos leases expirados pueden indicar que la duración es demasiado corta, que el heartbeat no funciona o que las herramientas no tienen timeout. Aumentar indefinidamente el lease oculta el problema y retrasa recuperación.
#Referencias
- SELECT y cláusulas de bloqueo, PostgreSQL:
FOR UPDATEySKIP LOCKED. - Transacciones, SQLite: un escritor y
BEGIN IMMEDIATE. - APIs idempotentes, AWS Builders Library: identidad de intención y resultados repetidos.