#La pregunta que diseña la persistencia
No empieces por «¿qué base de datos uso?». Empieza por «si el proceso desaparece aquí, ¿qué sabrá el siguiente?». Un agente puede caer después de obtener una respuesta, después de ejecutar una herramienta o después de guardar el resultado. Cada frontera deja información distinta.
Un checkpoint es un punto de recuperación que relaciona la posición de la trayectoria con el estado necesario para continuar: decisiones y observaciones aceptadas, operaciones pendientes y versiones de artefactos. No es un resumen para el modelo. Tampoco basta con guardar el número de iteración si los datos de esa iteración no están disponibles.
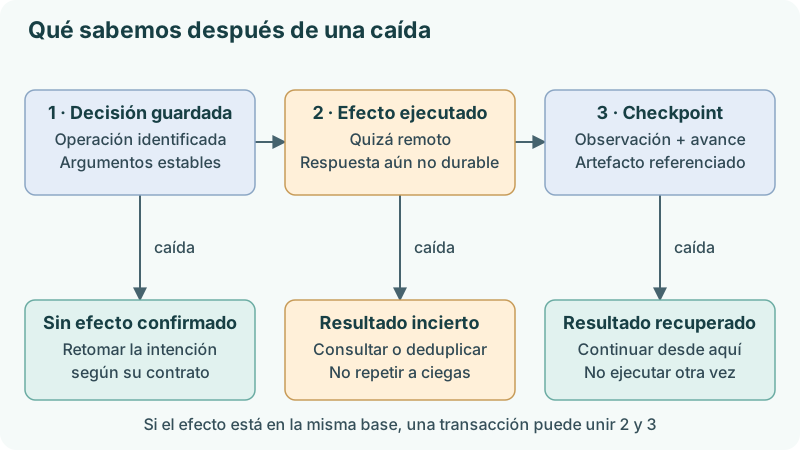
El tramo peligroso está entre producir un efecto y registrar que ocurrió. Una transacción local puede unir cambios de la misma base de datos; no puede envolver mágicamente una API externa.
#Una transacción resuelve un problema concreto
Una transacción agrupa escrituras que deben confirmarse juntas. COMMIT las acepta; ROLLBACK las deshace si aún no se han confirmado. Si guardas la observación de una herramienta y avanzas el cursor del run, ambas escrituras deben coincidir: avanzar sin observación pierde información; guardar observación sin avanzar puede repetir trabajo.
La atomicidad significa que se aceptan todas las escrituras de la transacción o ninguna. La durabilidad depende del motor, su configuración y un almacenamiento que cumpla sus garantías. La transacción no hace atómicos un archivo, un correo y una fila por el hecho de ejecutarlos dentro de un bloque de Python.
Usaremos SQLite: una base de datos embebida que vive en un archivo y se maneja con sqlite3, módulo de la biblioteca estándar. Es apropiada para aprender y para servicios pequeños en una sola máquina con volumen durable. No requiere levantar un servidor adicional.
#Un checkpoint ejecutable y una caída controlada
Este programa funciona con Python 3.12 o posterior. Crea una base temporal para no tocar tus datos. tempfile crea el directorio. @contextmanager convierte una función con yield en un bloque with: primero ejecuta BEGIN IMMEDIATE; al llegar a yield cede el control a las escrituras del cuerpo; si terminan bien, vuelve a la línea siguiente y hace COMMIT; si el cuerpo falla, la excepción se recibe en el punto del yield y activa ROLLBACK. El decorador no crea la transacción por sí solo: la crean nuestras sentencias SQL.
import json
import sqlite3
import tempfile
from contextlib import contextmanager
from pathlib import Path


@contextmanager
def transaction(db):
    db.execute("BEGIN IMMEDIATE")
    try:
        yield
        db.execute("COMMIT")
    except BaseException:
        if db.in_transaction:
            db.execute("ROLLBACK")
        raise


def open_db(path):
    db = sqlite3.connect(path, autocommit=True, timeout=5)
    db.execute("PRAGMA foreign_keys=ON")
    return db


def checkpoint(db, result, fail=False):
    with transaction(db):
        db.execute("INSERT INTO observations VALUES (?, ?)",
                   (1, json.dumps(result)))
        if fail:
            raise RuntimeError("Caída entre las dos escrituras")
        db.execute("UPDATE runs SET cursor=1 WHERE id='r-1'")


with tempfile.TemporaryDirectory() as directory:
    path = Path(directory) / "agent.db"
    db = open_db(path)
    db.executescript("""
        CREATE TABLE runs(id TEXT PRIMARY KEY, cursor INTEGER NOT NULL);
        CREATE TABLE observations(seq INTEGER PRIMARY KEY, result TEXT NOT NULL);
        INSERT INTO runs VALUES ('r-1', 0);
    """)
    try:
        checkpoint(db, {"answer": 42}, fail=True)
    except RuntimeError:
        pass
    db.close()

    db = open_db(path)
    assert db.execute("SELECT cursor FROM runs").fetchone()[0] == 0
    assert db.execute("SELECT COUNT(*) FROM observations").fetchone()[0] == 0
    checkpoint(db, {"answer": 42})
    db.close()

    db = open_db(path)
    assert db.execute("SELECT cursor FROM runs").fetchone()[0] == 1
    assert db.execute("SELECT COUNT(*) FROM observations").fetchone()[0] == 1
    db.close()
    print("Sin estado a medias; checkpoint recuperado")
autocommit=True deja el control a nuestras sentencias explícitas. Por eso usamos db.execute("COMMIT"), no db.commit(), que no realiza esa función en este modo del driver. BEGIN IMMEDIATE reserva la escritura al empezar. SQLite permite un escritor simultáneo; un segundo escritor espera hasta el timeout o recibe un error de bloqueo.
El except BaseException aquí es deliberado: se limita a limpiar la transacción y vuelve a lanzar el error, incluso una interrupción. No convierte todos los fallos en éxito. La prueba simula una excepción y reabre la conexión. Una prueba de caída abrupta mediante otro proceso se verá en el proyecto final; un rollback controlado no prueba por sí solo un corte de energía.
#No mantener la transacción abierta durante la inferencia
Una respuesta del modelo puede tardar decenas de segundos. Si la pides dentro de una transacción de escritura, bloquearás otras tareas durante ese tiempo. El recorrido correcto suele ser:
- Leer estado y versión.
- Preparar contexto y llamar al modelo fuera de la transacción.
- Abrir una transacción corta, comprobar que la versión sigue vigente y guardar la decisión.
- Ejecutar o reconciliar la operación.
- Guardar observación y avance en otra transacción corta.
Si el estado cambió durante la inferencia, descarta la propuesta o vuelve a evaluarla sobre el nuevo estado. Una cancelación recibida mientras el modelo pensaba debe impedir que su respuesta antigua desencadene nuevas acciones.
#Los tres casos de recuperación
| Lo que encuentra el siguiente worker | Qué puede concluir | Acción |
|---|---|---|
| No hay decisión guardada | No existe propuesta aceptada | Puede volver a inferir; quizá se pague otra llamada |
| Hay decisión, no hay resultado | La operación está pendiente o su efecto es incierto | Consultar su estado o repetir solo con garantía adecuada |
| Hay resultado y checkpoint | La observación es durable | Continuar sin ejecutar otra vez la herramienta |
Guardar la decisión antes de actuar fija qué se intentaba hacer. Si al reiniciar vuelves a preguntar al modelo y te devuelve otros argumentos, ya no estás reintentando la misma operación. Por eso se conserva la propuesta aceptada y su identidad.
Si una herramienta solo lee, repetir suele ser seguro respecto a efectos, pero puede devolver otra versión. Si la reproducibilidad importa, persiste la observación y su hash. Si crea un informe dentro de la misma base de datos, puedes unir informe, resultado y avance en una transacción. Si envía dinero o publica un archivo remoto, necesitas la idempotencia del destino.
#Un checkpoint también referencia los artefactos
Imagina que el mensaje durable dice «he modificado app.py», pero app.py solo existía en el disco temporal del worker. Tras perder el worker, el historial sigue ahí y el cambio no. La persistencia de conversación y la persistencia del workspace son dos problemas.
Una estrategia guarda el contenido del artefacto bajo una identidad estable, calcula su hash y solo después confirma una referencia desde el checkpoint. Si el proceso cae antes de confirmar la referencia, puede quedar un blob huérfano que un recolector elimina más tarde. La alternativa inversa —referenciar primero y subir después— produce checkpoints que apuntan a contenido inexistente.
En un repositorio de código, un commit o patch puede identificar una versión, pero también hay que conservar archivos nuevos necesarios y explicar dónde se almacenan. Variables de entorno, procesos en marcha y conexiones no forman parte de un commit.
#WAL, backups y versiones del esquema
WAL permite que lectores y un escritor progresen con menos interferencia, pero no convierte SQLite en una base con múltiples escritores simultáneos. Además crea archivos auxiliares. Copiar únicamente agent.db mientras está activo puede omitir cambios todavía presentes en el WAL. Para un backup online usa la API del motor:
source = sqlite3.connect("agent.db", autocommit=True)
destination = sqlite3.connect("agent-backup.db", autocommit=True)
try:
    source.backup(destination)
finally:
    destination.close()
    source.close()
Un backup solo es útil si has probado restaurarlo y comprobar sus invariantes. Para un servicio en varias máquinas con escrituras concurrentes, normalmente conviene una base de servidor y un procedimiento de backup propio. No pongas un archivo SQLite con WAL en una carpeta de red compartida entre workers.
Cuando cambie el esquema, añade una migración numerada y conserva compatibilidad con ejecuciones antiguas. Una migración de payload puede necesitar interpretar decisiones guardadas antes del despliegue. Versionar el formato permite detectar esa situación; borrar ejecuciones antiguas para que el código nuevo funcione destruye precisamente la continuidad que querías obtener.
#Qué prueba realmente una recuperación
No basta con que «vuelva a arrancar». Tras reiniciar comprueba que conserva el objetivo, no duplica operaciones ya confirmadas, detecta operaciones inciertas, puede localizar los artefactos y respeta cancelaciones. Ejecuta el fallo antes y después de cada frontera de confirmación.
La evidencia más valiosa no es el número de mensajes guardados, sino una invariancia: cada avance confirmado tiene todos los datos necesarios para explicar y continuar ese avance.
#Referencias
- sqlite3 y control de transacciones, Python: modos
autocommit, backup y parámetros. - Transacciones, SQLite:
BEGIN IMMEDIATE, commit y concurrencia. - Write-ahead logging, SQLite: WAL, archivos auxiliares y limitaciones.