#El problema aparece precisamente en un miss
Si cien peticiones piden una ficha y su clave caduca, las cien pueden encontrar ausencia y consultar simultáneamente el origen. El modelo cache-aside tenía un hit ratio excelente hace un segundo y aun así produce una avalancha. Aumentar el número de conexiones a la base de datos puede trasladar el atasco al disco, a los bloqueos o a otro servicio.
Hay dos escalas. Una clave caliente concentra muchas peticiones sobre el mismo dato. Una caída completa de Redis convierte todas las consultas en misses. La primera se mitiga coordinando la carga de esa clave; la segunda exige límites del origen y una respuesta de degradación explícita.
#Repartir las caducidades con jitter
Jitter significa añadir una pequeña variación aleatoria a un tiempo. Si precargas diez mil claves con TTL de sesenta segundos, probablemente caduquen juntas. Reparte su vencimiento para evitar ese pico:
import random

def ttl_producto():
    return random.randint(45, 60)

# En consultar(), del capítulo anterior:
# r.set(key, entrada, ex=ttl_producto())
random es un módulo estándar, suficiente para repartir tiempos; no genera contraseñas. Elegimos un máximo de sesenta porque es el límite admitido de esta copia. Si sumaras treinta a sesenta, habrías cambiado la promesa a noventa. Jitter ayuda entre muchas claves; no evita cien lecturas simultáneas de la misma clave que acaba de desaparecer.
#Un permiso temporal para rellenar una clave
SET carga:42 token NX PX 1500 crea una clave solo si no existe (NX) con vida de 1500 milisegundos (PX). Quien la crea intenta llenar la caché; los demás esperan brevemente a que aparezca el resultado, sirven una copia anterior admitida o rechazan con un error temporal. No deben ponerse todos a consultar el origen inmediatamente después de perder la elección.
El token identifica al propietario. Python incluye secrets para generar valores aleatorios difíciles de adivinar:
import secrets

token = secrets.token_hex(16)
ganado = r.set("curso:carga:42", token, nx=True, px=1500)
if ganado:
    print("Esta petición intenta rellenar la caché")
else:
    print("Otra petición puede estar rellenándola")
El fragmento usa el cliente r del capítulo anterior. No es una función completa de caché: falta decidir qué responder, cuánto esperar y qué hacer si vence el permiso. Una primera implementación conservadora puede dejarlo expirar tras publicar el resultado; pierde rapidez en un nuevo miss cercano, pero evita borrar por error un permiso ajeno. El siguiente capítulo añade liberación condicional mediante un script corto.
#Qué pasa cuando el propietario sigue vivo después del TTL
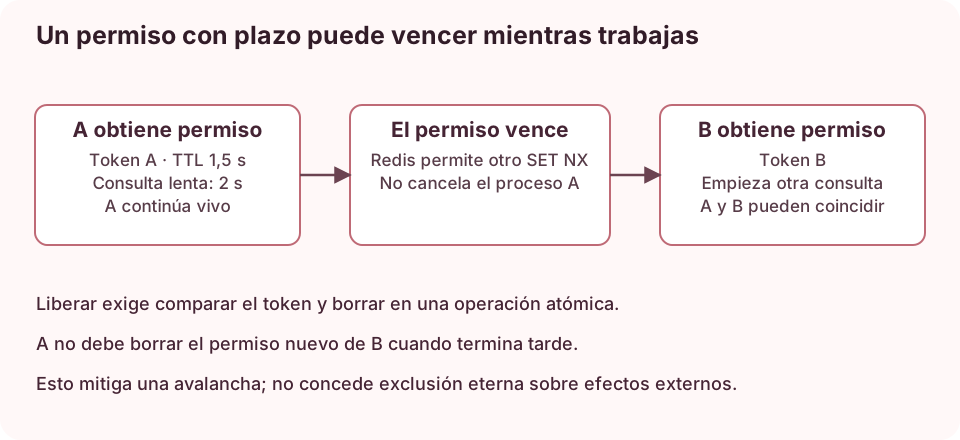
A obtiene el permiso, su consulta se atasca dos segundos y el permiso vence a los 1,5. B obtiene un permiso nuevo y también consulta. Ahora A y B trabajan a la vez. Redis no puede detener A por borrar una clave. El mecanismo reduce cargas duplicadas; no ofrece exclusión permanente ni protege por sí mismo un cobro, una escritura de archivo o un recurso externo.
Borrar carga:42 sin comparar su token puede retirar el permiso de B cuando A termina tarde. Comprobar GET y después hacer DEL también tiene una ventana. La comparación y el borrado deben suceder en un solo paso atómico. Incluso así, la liberación segura no impide que ambos hayan trabajado simultáneamente; son problemas distintos.
Para un efecto que solo un propietario vigente puede escribir, el receptor debe rechazar propietarios antiguos mediante una versión creciente o fencing. El capítulo de coordinación agéntica desarrolla ese mecanismo. Para una simple caché, suele ser mejor aceptar algo de trabajo duplicado y controlar cómo se publica el resultado.
#Limitar el origen aunque Redis no esté
Un semáforo controla cuántas operaciones pueden entrar en una región a la vez. threading.BoundedSemaphore pertenece a Python y sirve para una aplicación con varios hilos. Este ejemplo completo muestra el límite local; cargar es una función que tú entregas como argumento:
import threading

capacidad_origen = threading.BoundedSemaphore(4)

class OrigenSaturado(Exception):
    pass

def consultar_con_limite(cargar):
    conseguido = capacidad_origen.acquire(timeout=0.05)
    if not conseguido:
        raise OrigenSaturado("No hay capacidad para otra lectura")
    try:
        return cargar()
    finally:
        capacidad_origen.release()
acquire espera como máximo cincuenta milisegundos para obtener una de cuatro plazas. finally devuelve la plaza aunque falle la consulta. El timeout de entrada no cancela una consulta ya iniciada: también debes configurar su propio plazo en el cliente de base de datos o HTTP.
El límite es por proceso: cuatro procesos con cuatro plazas permiten dieciséis consultas. Cuenta todos los procesos, servidores y tareas de fondo al dimensionarlo. Una aplicación asíncrona usaría asyncio.Semaphore; no bloquees su bucle con esta versión de hilos.
Cuando no hay plaza, decide si devolver un estado HTTP temporal como 503, mostrar una funcionalidad reducida o usar una copia anterior dentro de una tolerancia documentada. La interfaz debe reflejar esa decisión. No devuelvas un precio viejo como si acabases de confirmar una operación sensible.
#No insistir indefinidamente en un servidor caído
Un circuit breaker deja de intentar una dependencia durante un intervalo después de acumular fallos; después permite algunas sondas para comprobar la recuperación. Evita gastar el timeout de Redis en cada petición cuando ya sabes que está caído. Tiene estado y carreras propios: empieza por timeouts pequeños, reintentos limitados y métricas antes de introducir una biblioteca adicional.
No almacenes exclusivamente en ese mismo Redis la capacidad de protegerte de su caída. La protección local del origen debe seguir funcionando sin él. Si los reintentos de cientos de procesos empiezan a la vez, añade jitter también al tiempo de reintento.
#Un ensayo que aporta información
Con una carga representativa, compara tres casos: caché caliente, caché vacía y Redis detenido. Mide lecturas simultáneas del origen, latencia de respuesta y rechazos, no solo peticiones por segundo. El caso vacío verifica el arranque; el caso detenido verifica la degradación. Aumentar el TTL puede mejorar el promedio sin solucionar ninguno de los dos.
Para esta guía se verificaron la expiración y el rechazo de liberar un token ajeno. Eso prueba el mecanismo pequeño. La capacidad de un servicio real depende de su consulta, procesos y hardware y debe medirse en su entorno. La documentación de patrones de locks explica por qué una concesión con plazo requiere razonar sobre pausas, tiempo y propietarios.