#Empieza con dos tiempos de negocio
¿Cuánto trabajo puedes perder después de un fallo y cuánto puedes tardar en recuperar el servicio? El primero suele llamarse RPO y el segundo RTO. No son propiedades que aparezcan por instalar Redis: dependen de la configuración, los backups, el almacenamiento, el tamaño de datos y los ensayos.
Una caché reconstruible puede arrancar vacía si el origen soporta la carga. Una cola de trabajos aceptados necesita conservar o reconstruir esas intenciones. Un backup de ayer no recupera por sí mismo lo aceptado esta mañana. El mini proyecto añade un registro de intenciones en SQLite precisamente para poder reconciliar, no porque AOF sustituya esa necesidad.
#RDB y AOF guardan cosas distintas
| Mecanismo | Qué conserva | Ventaja práctica | Coste o hueco |
|---|---|---|---|
| RDB | Fotografía de los datos en un momento | Archivo compacto, útil para backups y restauraciones | Pierde cambios posteriores a esa fotografía |
| AOF | Registro para reconstruir cambios | Menor ventana de pérdida según fsync |
Crecimiento, escritura y reescrituras |
| Ambos | Registro más fotografías | Opciones de recuperación complementarias | Hay que operar y comprobar ambos |
| Ninguno | Solo estado en memoria | Simple para copias reconstruibles | Reiniciar puede perder todo |
fsync pide al sistema operativo sincronizar los datos con el almacenamiento. appendfsync everysec busca un equilibrio y admite perder aproximadamente el último segundo en un fallo; no conviertas esa orientación en un contrato absoluto ante discos defectuosos o retrasos extremos. always sincroniza con mayor frecuencia y aumenta latencia. no delega más en el sistema operativo.
Redis moderno usa AOF multipartes: archivo base, incrementales y un manifiesto que relaciona sus piezas. Copiar solo un archivo llamado appendonly.aof de una receta antigua no es un backup correcto. Una reescritura compacta operaciones para reconstruir el estado actual; no conserva necesariamente todo el historial de negocio.
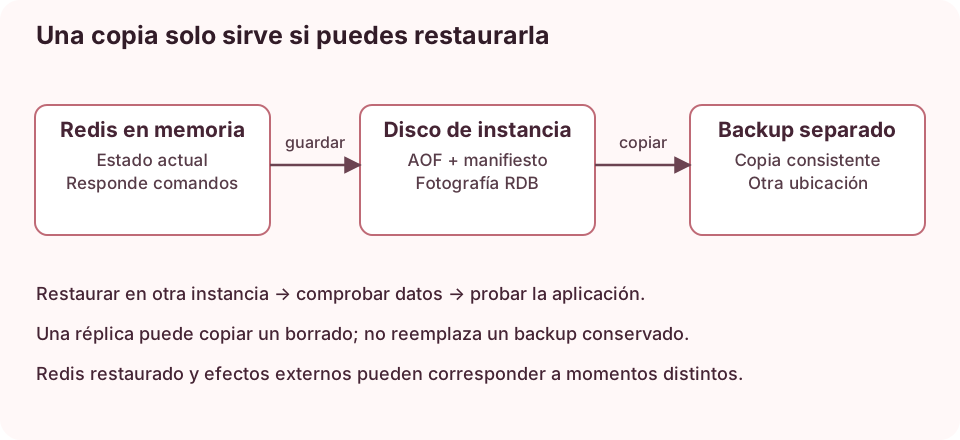
#Una instancia duradera separada de las prácticas anteriores
Usaremos otro nombre, puerto y volumen para que el experimento no cambie la instancia del curso. Un volumen permite que los archivos sobrevivan al reemplazo del contenedor.
docker volume create redis-durable-datos
docker run -d --name redis-durable \
  -p 127.0.0.1:6381:6379 \
  --mount type=volume,src=redis-durable-datos,dst=/data \
  redis:8.2.3-alpine \
  redis-server --appendonly yes --appendfsync everysec \
  --save '60 1' --maxmemory 128mb --maxmemory-policy noeviction
save '60 1' programa una fotografía cuando se cumplan sesenta segundos y al menos un cambio desde el guardado correspondiente; no significa escribir cada clave de inmediato. noeviction rechaza escrituras que necesiten más memoria al alcanzar el límite, en lugar de expulsar tareas silenciosamente. El límite no representa toda la RAM consumida por el proceso; lo dimensionaremos en el siguiente capítulo.
docker exec redis-durable redis-cli SET curso:durable conservado
docker exec redis-durable redis-cli INFO persistence
docker restart redis-durable
docker exec redis-durable redis-cli GET curso:durable
Espera a que PING responda tras arrancar. Debes recuperar conservado. Un reinicio ordenado acredita recuperación tras parada normal. Para probar un proceso terminado abruptamente, espera a que la política de sincronización haya tenido ocasión de actuar, usa docker kill redis-durable, arráncalo con docker start redis-durable y comprueba el valor. Esto no simula un corte de energía del disco: el kernel del host y su caché siguen vivos.
#Hacer una copia que puedas restaurar
Para una práctica diminuta, SAVE produce una fotografía consistente de forma bloqueante. Durante la operación Redis no atiende normalmente otros comandos, así que no la conviertas en una tarea habitual de un servidor grande. Allí usarías BGSAVE, comprobarías rdb_bgsave_in_progress=0 y rdb_last_bgsave_status=ok, y copiarías el archivo terminado conforme al procedimiento de la versión.
mkdir -p redis-backups
docker exec redis-durable redis-cli SAVE
docker cp redis-durable:/data/dump.rdb redis-backups/dump.rdb
docker exec redis-durable redis-cli SET curso:durable cambiado-despues
El cambio posterior permite distinguir la instancia actual de la copia. Conserva el archivo fuera del servidor que quieres proteger, con acceso restringido, cifrado y una política de retención adecuada a sus datos. No basta con dejarlo en otra carpeta del mismo disco si el riesgo es perder ese disco.
#Restaurar sin pisar el servidor original
docker volume create redis-restaurado-datos
docker create --name redis-restaurado \
  -p 127.0.0.1:6382:6379 \
  --mount type=volume,src=redis-restaurado-datos,dst=/data \
  redis:8.2.3-alpine redis-server --save '' --appendonly no
docker cp redis-backups/dump.rdb redis-restaurado:/data/dump.rdb
docker start redis-restaurado
docker exec redis-restaurado redis-cli GET curso:durable
docker create prepara el contenedor sin arrancarlo, de forma que colocas la fotografía antes de que Redis la lea. Recuperas conservado, mientras el servidor original contiene cambiado-despues. Esta diferencia demuestra que realmente arrancaste desde la copia. En un caso real valida varias claves conocidas, tipos, cantidades, grupos y pendientes de Streams, y ejecuta una operación representativa de la aplicación.
Una clave cuyo TTL ya venció no reaparece por restaurar una fotografía antigua: los tiempos de expiración siguen importando. Si restauras un Stream anterior a un ACK, puede reaparecer pendiente un trabajo cuyo efecto ya ocurrió fuera de Redis. El receptor idempotente es necesario también en recuperación desde backup.
#Copia, réplica y confirmación no son equivalentes
Una réplica recibe cambios de otra instancia y ayuda con disponibilidad o ciertas lecturas. También puede recibir un borrado accidental. Un backup permite volver a un punto conservado independientemente. La replicación normalmente es asíncrona: una respuesta al cliente no implica que todas las réplicas hayan persistido esa escritura.
WAIT permite esperar confirmaciones de recepción de réplicas para escrituras previas de esa conexión. Reduce ciertos riesgos, pero no convierte el conjunto en una transacción con tu base de datos ni elimina toda pérdida durante un failover. No añadas WAIT al azar sin decidir cuántas réplicas, qué timeout y qué respuesta dar si no se alcanza el objetivo.
#Una restauración es también un procedimiento de aplicación
Antes de reabrir productores y consumidores, identifica desde qué punto recuperaste Redis y desde cuál recuperaste el receptor de efectos. Si restauras SQLite a ayer y Redis a hoy, algunos recibos pueden faltar; si restauras Redis a ayer y SQLite a hoy, aparecerán repeticiones que debes reconocer. Define una identidad que sobreviva, qué registro manda y cómo reconciliar faltantes.
Para terminar el laboratorio, elimina solo sus recursos después de conservar lo que quieras revisar:
docker rm -f redis-durable redis-restaurado
docker volume rm redis-durable-datos redis-restaurado-datos
La documentación oficial de persistencia explica RDB y AOF, y la de replicación aclara los límites de WAIT. Antes de depender de un backup, mide el tiempo completo hasta que la aplicación vuelve a responder y comprueba el trabajo perdido o repetido.