#Una tabla no es una lista Python guardada
Una base relacional guarda filas con columnas definidas y permite consultar conjuntos sin cargarlos enteros en Python. Una clave primaria identifica una fila de forma única. Una clave foránea apunta a otra fila y permite que la base compruebe que la relación existe. SQL es el lenguaje de operaciones que entiende la base; el ORM de Django construye ese SQL a partir de expresiones Python.
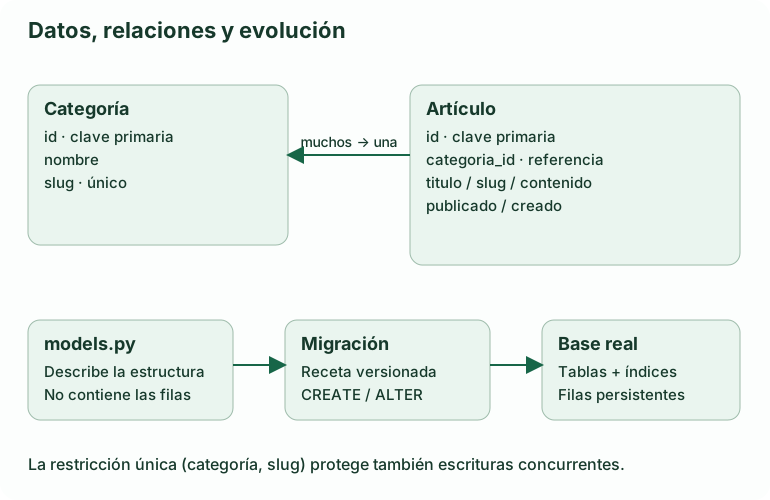
En la web de artículos, una categoría puede contener muchos artículos; cada artículo tiene una categoría. No copiamos el nombre de la categoría en cada artículo, porque al renombrarla tendríamos que corregir todas las copias. Guardamos una referencia a su identificador.
#Elegir campos por el significado de los datos
Sustituye articulos/models.py por el siguiente modelo completo:
from django.db import models


class Categoria(models.Model):
    nombre = models.CharField(max_length=80)
    slug = models.SlugField(unique=True)

    def __str__(self):
        return self.nombre


class Articulo(models.Model):
    categoria = models.ForeignKey(
        Categoria, on_delete=models.PROTECT, related_name="articulos"
    )
    titulo = models.CharField(max_length=120)
    slug = models.SlugField()
    contenido = models.TextField()
    publicado = models.BooleanField(default=False)
    creado = models.DateTimeField(auto_now_add=True)

    class Meta:
        constraints = [
            models.UniqueConstraint(
                fields=["categoria", "slug"], name="articulo_slug_por_categoria"
            )
        ]
        indexes = [models.Index(fields=["publicado", "-creado", "-id"])]

    def __str__(self):
        return self.titulo
Heredar de models.Model permite que Django descubra campos y genere consultas. Una instancia representa una fila; la clase representa su tipo. id se añade automáticamente; pk es el nombre genérico para acceder a la clave primaria. __str__ solo define una representación legible, por ejemplo en el administrador: no guarda ni busca datos por sí mismo.
SlugField es texto pensado para identificadores como primer-articulo. No lo convierte automáticamente desde el título. BooleanField distingue publicado de borrador. auto_now_add asigna la fecha al crear, no cada vez que guardas. Para dinero utiliza DecimalField, no un FloatField cuya representación binaria puede introducir aproximaciones. Para instantes, usa fechas con zona horaria; para «cumpleaños», una fecha sin hora puede ser lo correcto.
#Relaciones y borrado deliberado
En la tabla de artículos, la columna real de la relación se llama categoria_id. articulo.categoria_id lee ese identificador; articulo.categoria obtiene el objeto relacionado y puede generar una consulta adicional. related_name="articulos" permite recorrer la relación inversa: categoria.articulos.all().
PROTECT impide borrar desde Django una categoría que todavía tiene artículos. CASCADE borraría también los objetos dependientes a través del mecanismo de eliminación del ORM; SET_NULL conservaría el artículo sin categoría y exigiría null=True. No elijas cascadas por ahorrar mensajes de error: borrar una organización con facturas o reservas históricas puede ser una decisión de negocio incorrecta. La política on_delete es de Django; no presupongas que toda eliminación ejecutada mediante SQL externo reproduce las mismas cascadas.
null=True permite NULL en la base: ausencia de valor. blank=True permite un campo vacío en la validación de formularios/modelo. Son decisiones distintas. En texto suele bastar la cadena vacía, evitando tener dos representaciones de «sin texto»; una relación opcional sí necesita normalmente NULL.
#La garantía vive donde ocurre la escritura
Una restricción de base de datos es una regla comprobada al escribir, incluso si dos procesos actúan a la vez o alguien evita tu formulario. Una validación Python permite explicar antes el problema al usuario, pero puede quedar obsoleta antes de guardar.
UniqueConstraint impide repetir el mismo slug dentro de la misma categoría; permite introduccion en dos categorías distintas. Un índice acelera ciertas consultas a cambio de espacio y trabajo en cada escritura. El índice del ejemplo está pensado para filtrar publicados y ordenarlos por fecha e identificador; lo evaluaremos con consultas reales en el próximo capítulo.
save() no llama automáticamente a full_clean(). Si construyes una instancia desde un script y quieres validación del modelo, llama explícitamente a full_clean() y trata su ValidationError; conserva también las restricciones que protegen invariantes concurrentes. Aun después de validar, save() puede lanzar IntegrityError por una carrera.
#Modelo, migración y base son tres estados distintos
python manage.py makemigrations articulos
python manage.py sqlmigrate articulos 0001
python manage.py migrate
python manage.py showmigrations articulos
makemigrations compara modelos con el historial de migraciones, no compara mágicamente cada fila de la base. Genera una receta versionada. sqlmigrate muestra la traducción SQL de esa receta para tu motor; observarás CREATE TABLE, claves e índices. migrate la aplica y registra su ejecución; [X] en showmigrations indica que está aplicada en esa base.
Conserva modelos y migraciones juntos en Git. Un compañero o el servidor debe ejecutar la misma receta, no generar una distinta en producción. No borres una migración ya compartida para «limpiar» el historial: crea otra que corrija la estructura.
#Crear filas y demostrar que persisten
Abre python manage.py shell y ejecuta:
from articulos.models import Articulo, Categoria

categoria, _ = Categoria.objects.get_or_create(
    slug="python", defaults={"nombre": "Python"}
)
articulo = Articulo.objects.create(
    categoria=categoria,
    titulo="Primera publicación",
    slug="primera-publicacion",
    contenido="Una explicación que sigue aquí después de reiniciar.",
    publicado=True,
)
print(articulo.pk, articulo.categoria_id)
objects es el gestor que inicia consultas. create hace un INSERT y devuelve la instancia guardada. get_or_create devuelve (objeto, creado); aquí _ indica que no utilizamos el segundo resultado. Su protección frente a duplicados requiere una restricción adecuada, como el slug único de la categoría. Repetir el create del artículo produce un conflicto: lo hemos diseñado así.
Sal de la shell, vuelve a abrirla e imprime Articulo.objects.get(pk=articulo_id) sustituyendo articulo_id por el número observado. No necesitas que runserver haya estado encendido: la base conserva las filas independientemente del proceso que las creó.
Registra los modelos en articulos/admin.py:
from django.contrib import admin
from .models import Articulo, Categoria

admin.site.register([Articulo, Categoria])
Ejecuta python manage.py createsuperuser, inicia el servidor y abre /admin/. El administrador es útil para operación interna, no una interfaz pública con aislamiento por organización. Una cuenta con permisos globales puede ver más de lo que permitirá después nuestra web de usuarios.
#Añadir un campo cuando ya existen datos
Supón que necesitas un resumen obligatorio. Añadir directamente resumen = models.CharField(max_length=200) deja una pregunta sin respuesta: ¿qué resumen reciben las filas existentes? No introduzcas un texto vacío permanente solo para que la migración pase sin pensar en su significado.
Un cambio compatible puede hacerse en etapas:
- Añadir
resumen = models.CharField(max_length=200, blank=True, default="")y migrar. El código nuevo admite filas antiguas. - Publicar código que escriba el campo y pueda leer todavía un resumen vacío.
- Rellenar filas antiguas en lotes controlados y verificar que no quedan pendientes.
- Exigir el campo en formularios y, si es una invariante real, añadir una restricción que prohíba el vacío. Retirar la compatibilidad antigua después.
Una migración de datos usa RunPython. Debe obtener el modelo histórico con apps.get_model, no importar la clase actual que puede haber cambiado cuando esa migración se ejecute años después. Este fragmento ilustra una migración posterior a la adición del campo; no lo añadas si no has realizado esa evolución:
from django.db import migrations


def rellenar(apps, schema_editor):
    Articulo = apps.get_model("articulos", "Articulo")
    alias = schema_editor.connection.alias
    filas = Articulo.objects.using(alias).filter(resumen="")
    for articulo in filas.iterator(chunk_size=500):
        articulo.resumen = articulo.contenido[:200]
        articulo.save(using=alias, update_fields=["resumen"])


class Migration(migrations.Migration):
    dependencies = [("articulos", "0002_articulo_resumen")]
    operations = [migrations.RunPython(rellenar, migrations.RunPython.noop)]
La dependencia debe coincidir con el nombre real generado. noop significa que revertir no deshace el contenido; no es una recuperación mágica del texto previo. En una tabla grande, una operación por fila dentro de una migración puede mantener transacciones demasiado largas: separa el relleno en un comando reanudable y comprueba su progreso antes de endurecer la restricción.
Comprobación: intenta crear dos artículos con la misma categoría y slug; observa el fallo. Intenta borrar la categoría y explica por qué se protege. Antes de una nueva migración, responde qué pasa con una fila antigua y con un proceso que todavía ejecute el código anterior.