#Construir una consulta no es ejecutarla
Un QuerySet describe una consulta pendiente: filtros, orden y relaciones que quieres obtener. Al construirlo no tienes todavía todas las filas en memoria. Se evalúa cuando necesitas sus resultados, por ejemplo al recorrerlo, convertirlo en lista o evaluar su verdad. Esta separación permite que la base filtre antes de enviar datos a Python.
Continúa con los modelos del capítulo anterior. En python manage.py shell:
from articulos.models import Articulo

consulta = Articulo.objects.filter(publicado=True).order_by("-creado", "-pk")
print(consulta.query)
filas = list(consulta[:20])
print(len(filas))
consulta.query muestra el SQL previsto sin ejecutar una lectura de filas. [:20] se traduce en un límite, y list ejecuta esa consulta limitada. Un print(consulta) sí puede hacer una consulta para su representación. La caché interna de un QuerySet evaluado pertenece a ese objeto Python; no es una caché compartida entre peticiones ni una garantía de datos actuales.
#Pedir exactamente la respuesta necesaria
from django.db.models import Q

hay_borradores = Articulo.objects.filter(publicado=False).exists()
numero = Articulo.objects.filter(publicado=True).count()
titulos = list(Articulo.objects.filter(publicado=True).values_list("titulo", flat=True)[:20])
coincidencias = Articulo.objects.filter(
    Q(titulo__icontains="python") | Q(contenido__icontains="python")
)
exists() pregunta por existencia; count() pide un recuento a la base; values_list obtiene columnas sin crear modelos completos. flat=True devuelve una lista de valores simples cuando solo seleccionas una columna. Q permite combinar condiciones: | significa OR, & AND y ~ negación. Los dobles guiones bajos separan campo, recorrido de relación y operación: categoria__slug="python" filtra por una columna de la categoría relacionada.
No llames a exists() y después recorras el mismo conjunto si necesitas las filas de todas formas: puedes introducir dos viajes cuando uno bastaba. Tampoco uses len(list(consulta)) para contar millones de registros. Elige según la pregunta, no según una regla de «este método siempre es más rápido».
El ORM parametriza valores, lo que evita concatenarlos dentro del SQL. Si necesitas SQL manual, usa parámetros del driver; interpolar texto recibido del usuario con f-strings anula esa protección. Parametrizar valores no permite parametrizar nombres arbitrarios de columnas: para ordenar desde una URL usa un mapa de nombres permitidos.
#Hacer visible el problema N+1
Supón una página de 20 artículos que muestra su categoría. Una consulta obtiene los artículos y cada acceso a articulo.categoria.nombre puede hacer otra. El resultado parece correcto, pero has convertido una pantalla pequeña en 21 consultas.
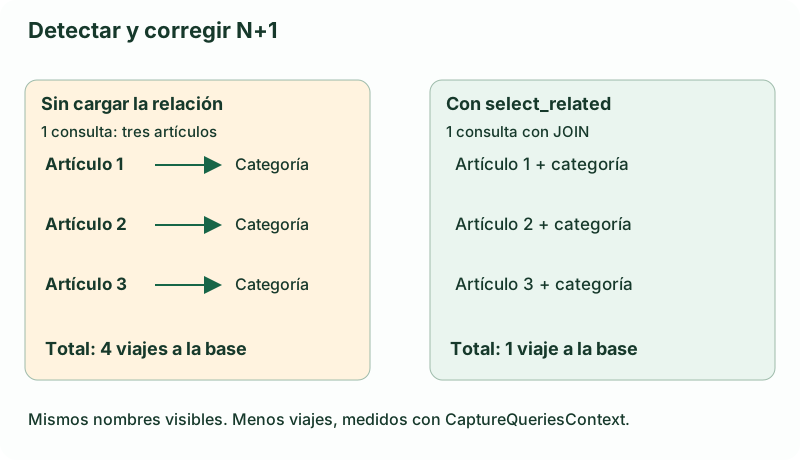
Este experimento funciona en la shell del proyecto y mide consultas reales, no tiempos estimados. Prepara tres artículos de práctica con una categoría:
from django.db import connection
from django.test.utils import CaptureQueriesContext
from articulos.models import Articulo, Categoria

categoria, _ = Categoria.objects.get_or_create(slug="medicion", defaults={"nombre": "Medición"})
for numero in range(3):
    Articulo.objects.get_or_create(
        categoria=categoria, slug=f"prueba-{numero}",
        defaults={"titulo": f"Prueba {numero}", "contenido": "Texto", "publicado": True},
    )

with CaptureQueriesContext(connection) as registro:
    nombres = [a.categoria.nombre for a in Articulo.objects.filter(categoria=categoria)]
print(len(registro))  # 4: artículos + tres accesos a categoría

with CaptureQueriesContext(connection) as registro:
    nombres = [a.categoria.nombre for a in Articulo.objects.filter(categoria=categoria).select_related("categoria")]
print(len(registro))  # 1
with entra en un contexto que recopila las consultas ejecutadas durante ese bloque; al salir conserva el registro. select_related hace un JOIN para relaciones de un único objeto, como una ForeignKey. Que los tres artículos compartan categoría no crea una caché global automática de esa categoría entre las instancias.
Para una relación de varios objetos, prefetch_related hace consultas separadas y asocia los resultados en Python. Por ejemplo, Categoria.objects.prefetch_related("articulos") puede resolver categorías y sus artículos en dos consultas. Si después llamas a categoria.articulos.filter(publicado=True), has pedido una consulta diferente y puedes perder el beneficio. Usa Prefetch con un QuerySet filtrado y to_attr cuando necesites una colección concreta.
#Agregar en la base, no en un bucle
from django.db.models import Count, Q
from articulos.models import Categoria

categorias = Categoria.objects.annotate(
    publicados=Count("articulos", filter=Q(articulos__publicado=True))
).order_by("nombre", "pk")
for categoria in categorias:
    print(categoria.nombre, categoria.publicados)
annotate añade un valor calculado a cada fila de resultado. La base agrupa y cuenta; no necesitas una consulta .count() por categoría. Unir varias relaciones de muchos elementos puede multiplicar filas y alterar agregados: inspecciona SQL y resultados con datos pequeños donde conozcas la respuesta. distinct=True puede resolver ciertos conteos, pero no corrige automáticamente cualquier combinación de joins.
#Paginar con un orden determinista
En articulos/views.py, sustituye listado por esta función; en el siguiente capítulo crearemos su template:
from django.core.paginator import Paginator
from django.shortcuts import render
from .models import Articulo


def listado(request):
    consulta = (
        Articulo.objects.filter(publicado=True)
        .select_related("categoria")
        .order_by("-creado", "-pk")
    )
    pagina = Paginator(consulta, 20).get_page(request.GET.get("pagina"))
    return render(request, "articulos/listado.html", {"pagina": pagina})
Paginator divide la consulta en páginas de 20. get_page tolera parámetros ausentes o inválidos y devuelve una página válida. -pk rompe empates entre fechas iguales: sin un orden total, una fila podría aparecer en posiciones ambiguas. La paginación habitual cuenta filas y utiliza OFFSET; saltar a una página muy lejana puede costar más porque la base tiene que atravesar resultados anteriores.
Cuando el volumen o la frecuencia de inserción lo justifiquen, usa paginación por cursor: «dame 20 registros anteriores a este par (creado, id)». El predicado para orden descendente combina creado < fecha con creado = fecha AND id < identificador. El cursor necesita validación y un contrato de filtros estable. No añadas esta complejidad a un listado de cientos de filas sin medir un problema real.
#Índices que responden a consultas concretas
Un índice es una estructura adicional que ayuda a localizar u ordenar filas sin recorrer toda la tabla. No acelera cualquier operación: un índice sobre una fecha no garantiza una búsqueda rápida por contenido__icontains. Un índice compuesto tiene un orden de columnas; filtrar por igualdad antes de ordenar suele permitir aprovecharlo mejor.
print(
    Articulo.objects.filter(publicado=True)
    .order_by("-creado", "-pk")[:20]
    .explain()
)
explain pide el plan elegido por la base. En tablas pequeñas puede escoger un recorrido completo aunque exista un índice: leer pocas páginas puede ser más barato. Mide con un volumen representativo, observa filas estimadas y consulta real. En PostgreSQL, EXPLAIN ANALYZE ejecuta la consulta; no lo lances a ciegas sobre escrituras o consultas costosas en producción.
only y defer retrasan columnas. Son útiles para campos grandes que no necesitas, pero acceder después a cada campo retrasado puede recrear un N+1. Para exportaciones grandes, iterator(chunk_size=...) reduce la caché de objetos en Python, aunque el comportamiento del cursor depende del motor y no elimina el coste de producir y transferir todas las filas.
Comprobación: el experimento debe pasar de 4 consultas a 1 conservando los mismos nombres. Después añade más artículos y verifica que la vista solo pide una página. Optimizar significa conservar la respuesta y reducir trabajo medido, no añadir select_related a todas partes por costumbre.