#Un despliegue es una cadena de responsabilidades
En desarrollo, runserver recarga código y sirve estáticos para ayudarte. Un servicio público necesita procesos supervisados, HTTPS, secretos, una base operable y un procedimiento para actualizar y recuperar. No hace falta comenzar con Kubernetes ni varios centros de datos; una máquina con límites y responsabilidades claras puede ser una arquitectura profesional para un servicio de tamaño moderado.
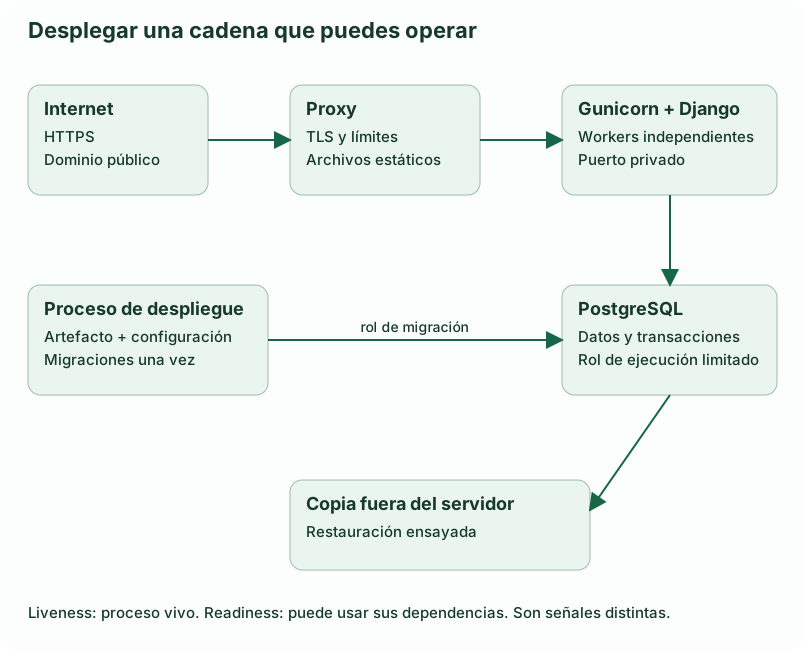
El proxy inverso recibe la conexión pública, termina TLS y dirige peticiones a la aplicación. Gunicorn ejecuta procesos Python y habla el contrato WSGI con Django. PostgreSQL conserva datos y coordina escrituras. Los estáticos proceden del artefacto; los uploads, si los hay, requieren almacenamiento persistente separado. Los detalles de redes y contenedores se desarrollan en Docker; aquí importan las decisiones propias de Django.
#Configuración que falla de forma visible
El mismo código puede ejecutarse con ajustes diferentes para desarrollo y producción. Elige valores por una configuración explícita, no por detectar si «parece un servidor». Lee secretos del entorno o ficheros de secretos; mantén una validación que impida arrancar con valores ausentes.
# Fragmento de ajustes de producción.
import os

DEBUG = False
SECRET_KEY = os.environ["DJANGO_SECRET_KEY"]
ALLOWED_HOSTS = [host.strip() for host in os.environ["DJANGO_ALLOWED_HOSTS"].split(",") if host.strip()]
SESSION_COOKIE_SECURE = True
CSRF_COOKIE_SECURE = True
SECURE_SSL_REDIRECT = True
DEBUG=False evita respuestas de diagnóstico con datos internos. SECRET_KEY firma estructuras sensibles de Django; no debe estar en el repo ni reutilizarse entre desarrollo y producción. ALLOWED_HOSTS valida nombres de host, no es una lista de usuarios permitidos ni una configuración de CORS. Las cookies Secure requieren HTTPS; activarlas mientras pruebas por HTTP puede parecer un login que nunca conserva sesión.
Si el proxy termina HTTPS y conecta por HTTP a Gunicorn, Django necesita saber que la petición original era segura. SECURE_PROXY_SSL_HEADER se configura solo cuando el proxy controlado sobrescribe esa cabecera y Gunicorn no es accesible saltándose el proxy. Con una configuración equivocada puedes crear un bucle de redirección o aceptar una cabecera falsificada.
CSRF_TRUSTED_ORIGINS contiene orígenes completos —esquema y host— que pueden enviar solicitudes cuando tu arquitectura los necesita. No lo conviertas en una lista indiscriminada para ocultar un fallo de proxy. Una web del mismo origen con HTTPS y cabeceras correctas no necesita abrir confianza a otros dominios.
#Construir una versión reproducible
Fija Python y dependencias probadas en un artefacto: por ejemplo, una imagen Docker o un entorno construido desde versiones bloqueadas. pip freeze registra versiones instaladas, pero un proceso reproducible debe además definir la versión de Python, plataforma y origen de paquetes; los hashes mejoran la verificación de artefactos. Instalar siempre «lo último» al iniciar cada servidor produce versiones distintas sin revisión.
En el proyecto de práctica usamos un rango 5.2 para recibir parches; antes de desplegar, resuelve versiones, prueba y conserva ese resultado. Para una actualización de seguridad, crea un nuevo artefacto y ejecuta las pruebas relevantes. No dejes una versión fija indefinidamente por miedo a cambiar ni cambies dependencias en vivo sin saber qué se ejecuta.
python manage.py check --deploy --settings=config.settings_production
python manage.py makemigrations --check --dry-run
python manage.py test
python manage.py collectstatic --noinput --settings=config.settings_production
Estos comandos usan el módulo config.settings_production completo que se construye en la última parte del proyecto; si todavía sigues la práctica de artículos, lee primero su preparación antes de ejecutar comandos con ese módulo.
check --deploy detecta configuraciones conocidas, pero no prueba que el firewall, los permisos de organización o las copias funcionen. makemigrations --check evita publicar modelos que requieren una receta no incluida. collectstatic reúne recursos y, con almacenamiento de manifiesto, genera nombres basados en contenido para que una nueva versión no dependa de borrar cachés del navegador.
#Un rol de base para operar, otro para migrar
El proceso web no necesita ser administrador PostgreSQL. Un rol de migración crea y modifica tablas; un rol de ejecución lee y escribe los datos que necesita. Separarlos reduce el daño de una credencial comprometida y evita que un fallo de aplicación cambie el esquema.
Este ejemplo se ejecuta con psql y una cuenta administradora en una base de producción nueva, después de que reservas_migrador haya creado las tablas en el esquema public. Los nombres son ilustrativos; el proyecto final indica cómo sustituir sus credenciales de laboratorio:
CREATE ROLE reservas_app LOGIN;
\password reservas_app
GRANT CONNECT ON DATABASE reservas TO reservas_app;
GRANT USAGE ON SCHEMA public TO reservas_app;
GRANT SELECT, INSERT, UPDATE, DELETE ON ALL TABLES IN SCHEMA public TO reservas_app;
GRANT USAGE, SELECT ON ALL SEQUENCES IN SCHEMA public TO reservas_app;
ALTER DEFAULT PRIVILEGES FOR ROLE reservas_migrador IN SCHEMA public
  GRANT SELECT, INSERT, UPDATE, DELETE ON TABLES TO reservas_app;
ALTER DEFAULT PRIVILEGES FOR ROLE reservas_migrador IN SCHEMA public
  GRANT USAGE, SELECT ON SEQUENCES TO reservas_app;
\password es una orden interactiva de psql, no SQL enviado desde Django. Los permisos por defecto afectan a objetos creados en el futuro por ese rol; no a cualquier rol ni a tablas existentes, por eso aparecen ambos GRANT. Ejecuta estos comandos conectado a la base reservas. El usuario que los aplica debe ser propietario o tener autoridad para conceder esos permisos.
No otorgues CREATE sobre el esquema al rol web ni lo hagas propietario de tablas. La separación no implementa aislamiento entre organizaciones: con permisos de tabla, el rol sigue pudiendo leer todas sus filas; la aplicación debe filtrar y probar acceso. Para requisitos más exigentes puedes estudiar políticas de filas de PostgreSQL, pero introducirlas exige gestionar bien la identidad de organización en cada conexión y no sustituye comprender tu modelo actual.
#Supervisar procesos y distinguir salud
Un worker es un proceso de aplicación. Su memoria no se comparte automáticamente con otros workers: sesiones locales, cachés locales y variables globales pueden diferir. Más workers permiten más peticiones simultáneas, pero también más conexiones a la base y memoria. Presupuesta conexiones entre web, tareas, migraciones y administración; un pool no crea capacidad infinita en PostgreSQL.
Una comprobación de liveness pregunta si el proceso responde. Readiness pregunta si puede atender la operación que requiere sus dependencias. Si el proceso sigue vivo pero PostgreSQL está caído, reiniciar todo repetidamente puede empeorar el problema; la readiness puede anunciar indisponibilidad mientras se recupera la dependencia.
La comprobación de base debe ser ligera y acotada, como SELECT 1, sin exponer nombres de servidores, versiones o trazas al público. No prueba por sí sola que una reserva funcione: conserva también una comprobación funcional autenticada en un entorno controlado. Configura timeouts de conexión y sentencia para que las sondas no se conviertan en peticiones colgadas.
El supervisor —systemd o el runtime de contenedores— debe enviar una señal de parada, dar tiempo a terminar peticiones y matar después de un límite. La aplicación no debe requerir kill -9 como flujo habitual. El proyecto final muestra una unidad systemd y Gunicorn, sin convertir la lectura en un curso paralelo de administración Linux.
#Actualizar código y esquema sin apostar por el orden
Dos versiones pueden coexistir durante una sustitución. Si el código antiguo lee una columna que acabas de borrar, volver a esa versión no es un rollback viable. Utiliza una evolución en fases:
- Expandir: añade campos o tablas que el código antiguo tolere. Aplica la migración una vez.
- Cambiar: publica código que escriba y lea el nuevo formato conservando compatibilidad donde haga falta.
- Rellenar y comprobar: transforma datos existentes con una tarea que pueda reanudarse, midiendo pendientes y errores.
- Contraer: retira columnas o caminos antiguos cuando ya no haya procesos que los necesiten y exista recuperación comprobada.
No metas automáticamente makemigrations al arranque del contenedor. Las recetas se generan, revisan y versionan antes. Tampoco hagas que cada uno de cinco workers ejecute migraciones en paralelo. Un paso de despliegue controlado debe informar si falló y detener el cambio de versión.
Una migración puede tomar bloqueos o tardar mucho al tocar tablas grandes. Ensáyala con un volumen representativo, inspecciona su SQL y decide si necesita un cambio en etapas. Crear índices concurrentemente en PostgreSQL puede reducir ciertos bloqueos, pero requiere una migración no atómica y sus propias reglas de fallo; no añadas esa opción sin haber observado que un índice ordinario resulta inaceptable.
#Copias que sirven y límites que se miden
Define cuánto dato puedes perder y cuánto tiempo puedes estar recuperando: esas dos preguntas determinan frecuencia de backup y estrategia de restauración. Un dump diario puede ser suficiente para un proyecto interno y demasiado para reservas que no deben perder un día de actividad. No necesitas prometer cero pérdida para comenzar, pero sí saber qué prometes.
Ensaya restaurar en una base distinta, con roles y credenciales de aplicación, y comprueba una lectura y escritura reales. Incluye uploads si existen; un dump SQL no los contiene. Conserva copias fuera del fallo del servidor, limita acceso y documenta qué secreto necesitas para descifrarlas. Sigue el recorrido concreto de copias y restauración con Docker.
Observa latencia por ruta, errores, consultas, saturación de conexiones y espacio de disco. Los logs de acceso dicen qué petición ocurrió; los de aplicación explican fallos y cambios relevantes; un historial de negocio durable es otra cosa. Evita registrar contraseñas, tokens, cookies y cuerpos completos de formularios.
Comprobación: antes de declarar operable una versión, demuestra login y una escritura bajo Gunicorn, prueba el rechazo de permisos, confirma estáticos con DEBUG=False, ensaya una restauración y escribe qué versión de código podrías recuperar con el esquema actual. La última parte del mini proyecto reúne esos pasos alrededor de una aplicación completa.