#Qué construiremos y por qué ese problema
Un taller registra muestras de calidad de cada lote y pide un informe con cantidad, mínimo, máximo y media. El productor registra la petición y la envía a un Stream. Un consumidor genera el informe; si cae, otro recupera el trabajo. Puedes recorrer y entender el proyecto entero en estas tres páginas, sin descargar ningún paquete ni buscar piezas fuera de la explicación.
El efecto real será insertar un informe en SQLite, una base relacional en un archivo gestionada por el módulo estándar sqlite3. No estamos simulando un email o una impresión física y adjudicándoles sus garantías: esos efectos necesitarían un receptor propio. SQLite nos permite ver la transacción que conserva el resultado y reconoce una repetición.
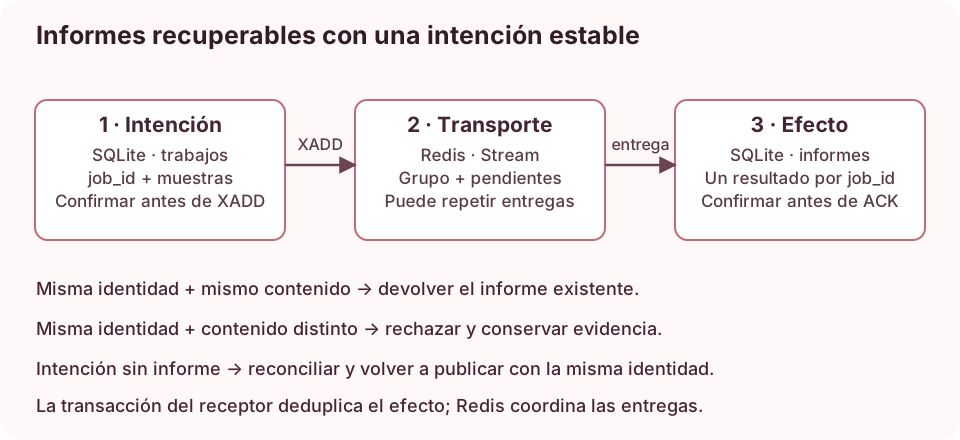
Trabajaremos en una sola máquina, con archivos Python pequeños que escribes a partir de los bloques de la web. Varios procesos consumidores pueden compartir este SQLite local. Para repartirlos entre máquinas, sustituirías esa frontera por una base o servicio accesible y mantendrías el contrato transaccional; no compartas el archivo SQLite por una red arbitraria esperando las mismas garantías.
#Dos identidades que no debes mezclar
| Identidad | Ejemplo | Qué representa |
|---|---|---|
job_id |
lote-A |
Una intención estable de generar un informe con unas muestras concretas |
| ID de Stream | …-0 |
Una publicación de esa intención en Redis |
Si se pierde la respuesta de XADD, el productor no sabe si publicó. Repetir con el mismo job_id puede generar otra entrada Redis; el receptor reconocerá la misma intención. Si cambias las muestras, usa una nueva identidad. Reutilizar lote-A con otro contenido será un error explícito.
En una aplicación web, el job_id podría crearse antes del primer envío y conservarse durante los reintentos. Generar uno nuevo en cada reintento destruye la deduplicación. El Stream ID es útil para ACK y diagnóstico, pero no identifica por sí solo una acción repetida de negocio.
#El modelo de datos conserva tres hechos
trabajos conserva lo que se pidió. informes conserva lo que ya se completó. rechazados conserva mensajes inválidos antes de retirarlos de pendientes. La clave primaria job_id impide dos filas de informe con la misma identidad; comparar el contenido evita interpretar una colisión como una repetición legítima.
Una tabla tiene filas y columnas. Una clave primaria es una columna cuyo valor no puede repetirse ni ser nulo. Una transacción agrupa cambios que deben confirmarse juntos. SQLite puede coordinar varios lectores, pero solo un escritor a la vez: el proyecto mantiene las transacciones breves y no hace llamadas de red mientras las tiene abiertas.
#Una representación estable del contenido
JSON permite escribir el mismo objeto con espacios u orden de campos distintos. Para comparar su significado en este contrato pequeño, validamos las muestras y las serializamos con campos ordenados y sin espacios adicionales. Solo admitimos entre una y cien muestras enteras entre cero y diez mil. Un límite de tamaño también es parte del diseño de la cola.
json.dumps({"muestras": [10, 20, 30]}, sort_keys=True, separators=(",", ":"))
# '{"muestras":[10,20,30]}'
type(x) is int excluye booleanos: en Python True también satisface isinstance(True, int), pero no representa una muestra en nuestro contrato. re.fullmatch comprueba que el identificador entero utiliza los caracteres permitidos. re es el módulo estándar de expresiones regulares; aquí solo define un alfabeto y una longitud, no un analizador complejo.
#El punto que impide duplicar el efecto
Dentro de aplicar, BEGIN IMMEDIATE obtiene el permiso de escritura de SQLite antes de comprobar si existe el informe. Si dos consumidores llegan juntos, uno espera; cuando pueda entrar, verá el resultado confirmado por el primero. La fila del informe es a la vez el efecto de este proyecto y su recibo de idempotencia.
# La función completa aparece debajo.
db.execute("BEGIN IMMEDIATE")
previo = db.execute("SELECT resultado FROM informes WHERE job_id=?", (job_id,)).fetchone()
El ? es un parámetro SQL: el motor trata el valor como dato, no como texto de una consulta concatenada. (job_id,) es una tupla de un elemento; la coma importa. fetchone() devuelve una fila o None. Primero se comprueba también que el cuerpo coincide con la intención registrada, para que un mensaje alterado no cree ni reutilice otro informe.
#Por qué hay dos gestores en with
closing(...), del módulo contextlib, garantiza que una conexión se cierre al salir. El segundo gestor, db, confirma la transacción si el bloque termina bien y la revierte si sale una excepción. with closing(...) as db, db: abre ambos de izquierda a derecha y los cierra en orden inverso: primero termina la transacción y después cierra la conexión.
El cálculo sobre cien números es corto y puede hacerse dentro de esta transacción. Para trabajo costoso, calcularías fuera y harías dentro únicamente comprobación y publicación; necesitarías conservar la misma identidad y decidir qué ocurre si cambian los datos. No mantengas una transacción bloqueando escritores mientras esperas una API.
#La pieza completa: almacen.py
Crea almacen.py con este bloque. INFORMES_DB permite elegir el archivo mediante una variable de entorno; sin ella usa informes.db en tu carpeta actual. iniciar() crea las tablas si faltan, sin borrar trabajo anterior.
Ver almacen.py completo: validación, intención, efecto y rechazos
import json
import os
import re
import sqlite3
from contextlib import closing

DB = os.environ.get("INFORMES_DB", "informes.db")


def canonico(job_id, muestras):
    if not isinstance(job_id, str) or not re.fullmatch(r"[A-Za-z0-9_-]{1,64}", job_id):
        raise ValueError("Identificador inválido")
    if not isinstance(muestras, list) or not 1 <= len(muestras) <= 100:
        raise ValueError("Usa entre 1 y 100 muestras")
    if any(type(x) is not int or not 0 <= x <= 10000 for x in muestras):
        raise ValueError("Cada muestra debe ser un entero entre 0 y 10000")
    return json.dumps({"muestras": muestras}, sort_keys=True, separators=(",", ":"))


def iniciar():
    with closing(sqlite3.connect(DB, timeout=5)) as db, db:
        db.executescript("""
        CREATE TABLE IF NOT EXISTS trabajos (
            job_id TEXT PRIMARY KEY, payload TEXT NOT NULL
        );
        CREATE TABLE IF NOT EXISTS informes (
            job_id TEXT PRIMARY KEY, payload TEXT NOT NULL,
            resultado TEXT NOT NULL
        );
        CREATE TABLE IF NOT EXISTS rechazados (
            message_id TEXT PRIMARY KEY, motivo TEXT NOT NULL,
            cuerpo TEXT NOT NULL
        );
        """)


def registrar(job_id, muestras):
    payload = canonico(job_id, muestras)
    with closing(sqlite3.connect(DB, timeout=5)) as db, db:
        db.execute("BEGIN IMMEDIATE")
        previo = db.execute("SELECT payload FROM trabajos WHERE job_id=?", (job_id,)).fetchone()
        if previo and previo[0] != payload:
            raise ValueError("La identidad ya corresponde a otro trabajo")
        db.execute("INSERT OR IGNORE INTO trabajos VALUES (?, ?)", (job_id, payload))
    return payload


def pendientes():
    with closing(sqlite3.connect(DB, timeout=5)) as db:
        return db.execute("""
            SELECT t.job_id, t.payload FROM trabajos t
            LEFT JOIN informes i ON i.job_id=t.job_id
            WHERE i.job_id IS NULL ORDER BY t.job_id LIMIT 100
        """).fetchall()


def aplicar(job_id, raw):
    datos = json.loads(raw)
    if not isinstance(datos, dict) or set(datos) != {"muestras"}:
        raise ValueError("Esquema desconocido")
    payload = canonico(job_id, datos["muestras"])
    with closing(sqlite3.connect(DB, timeout=5)) as db, db:
        db.execute("BEGIN IMMEDIATE")
        original = db.execute("SELECT payload FROM trabajos WHERE job_id=?", (job_id,)).fetchone()
        if not original or original[0] != payload:
            raise ValueError("El mensaje no coincide con la intención registrada")
        previo = db.execute("SELECT resultado FROM informes WHERE job_id=?", (job_id,)).fetchone()
        if previo:
            return "repetido", json.loads(previo[0])
        muestras = datos["muestras"]
        resultado = {"cantidad": len(muestras), "minimo": min(muestras),
                     "maximo": max(muestras), "media": sum(muestras) / len(muestras)}
        db.execute("INSERT INTO informes VALUES (?, ?, ?)",
                   (job_id, payload, json.dumps(resultado, sort_keys=True)))
    return "creado", resultado


def rechazar(message_id, cuerpo, motivo):
    with closing(sqlite3.connect(DB, timeout=5)) as db, db:
        db.execute("INSERT OR IGNORE INTO rechazados VALUES (?, ?, ?)",
                   (message_id, str(motivo)[:300], json.dumps(cuerpo, sort_keys=True)[:8192]))
INSERT OR IGNORE solo se usa después de verificar una intención ya registrada, o para hacer idempotente la conservación de un rechazo por message ID. No se emplea para esconder que el mismo job_id tenga otro cuerpo. El texto de rechazos se limita a 8192 caracteres; es una muestra diagnóstica, no un archivo ilimitado de mensajes hostiles.
pendientes() utiliza un LEFT JOIN: relaciona intenciones con informes y conserva las intenciones que todavía no tienen uno. El límite de cien evita convertir una reconciliación en una lectura ilimitada. Ordena por job_id para que el lote sea reproducible, no por prioridad de negocio.
#Comprobar el receptor antes de añadir Redis
Activa el entorno virtual del curso. En la misma carpeta donde guardaste el archivo, ejecuta:
python - <<'PYTEST'
import almacen
almacen.iniciar()
payload = almacen.registrar("prueba-local", [10, 20, 30])
print(almacen.aplicar("prueba-local", payload))
print(almacen.aplicar("prueba-local", payload))
try:
    almacen.registrar("prueba-local", [999])
except ValueError as error:
    print("Rechazo esperado:", error)
PYTEST
Espera primero creado, después repetido, ambos con media 20.0, y un rechazo al cambiar las muestras. Si repites todo el comando en el mismo archivo, las dos llamadas pueden decir repetido: conservar el efecto entre ejecuciones es precisamente el objetivo. Para un ensayo independiente, elige otro INFORMES_DB o un job_id nuevo.
Todavía no hemos distribuido trabajo. Acabamos de probar la frontera que hace seguras las futuras reentregas. En la página siguiente conectaremos el productor y los consumidores manteniendo el orden: intención duradera, publicación, efecto duradero y ACK.