#La promesa debe ser concreta
Una caché evita repetir una lectura costosa cuando muchas peticiones necesitan el mismo resultado. Antes de escribir código, define qué datos admite, durante cuánto tiempo pueden estar obsoletos y cómo se recuperan si Redis falla. “Que sea rápido” no responde a ninguna de esas preguntas.
Para una ficha de catálogo aceptamos una copia de treinta segundos; para decidir si se puede consumir un cupón usamos el origen con su control de concurrencia. Incluso dentro de una misma pantalla, datos distintos pueden tener tolerancias distintas. No caches decisiones de autorización sin pensar en cuánto tardaría en aplicarse una revocación.
#Cache-aside, paso a paso
Cache-aside significa que la aplicación consulta la caché y, si no encuentra una entrada, consulta el origen y guarda una copia. Redis no conoce automáticamente tu base de datos ni recibe sus cambios: la aplicación debe decidir cuándo leer, poblar e invalidar.
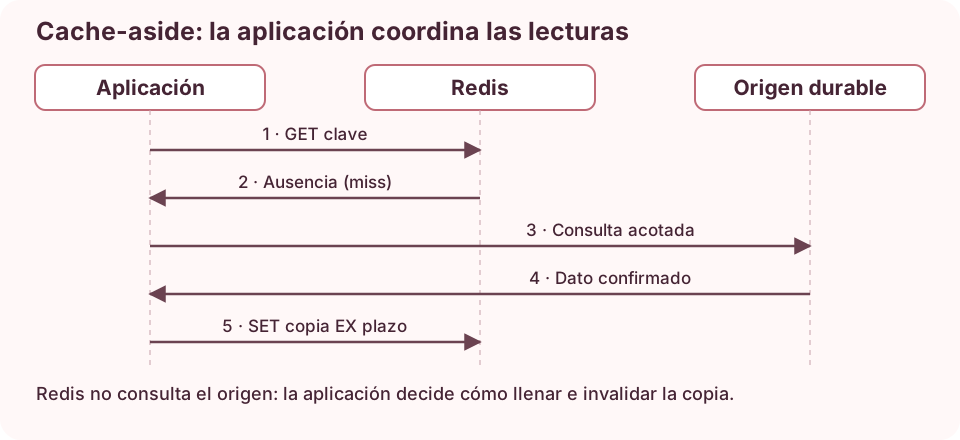
El acierto se llama hit y la ausencia miss. Un miss es normal, no un incidente. Distinto es que Redis no responda: quizá también puedas consultar el origen, pero perder toda la caché puede multiplicar la carga. El siguiente capítulo limita esa degradación.
#Un ejemplo completo, con un origen pequeño visible
Guarda este bloque como cache.py. El diccionario ORIGEN simula una base para ver las lecturas; no prueba durabilidad ni coordinación entre procesos. En una aplicación real, leer_origen ejecutaría una consulta parametrizada y acotada sobre la base de datos.
import json
import redis
from redis.backoff import NoBackoff
from redis.retry import Retry

r = redis.Redis(host="127.0.0.1", port=6380, decode_responses=True,
                socket_connect_timeout=0.3, socket_timeout=0.5,
                retry=Retry(NoBackoff(), 0))
ORIGEN = {42: {"nombre": "Lámpara", "precio_centimos": 3900}}

def clave(producto_id):
    if type(producto_id) is not int or producto_id <= 0:
        raise ValueError("Identificador inválido")
    return f"curso:producto:v1:{producto_id}"

def leer_origen(producto_id):
    print("Lectura del origen", producto_id)
    producto = ORIGEN.get(producto_id)
    return dict(producto) if producto is not None else None

def consultar(producto_id):
    key = clave(producto_id)
    try:
        raw = r.get(key)
    except (redis.ConnectionError, redis.TimeoutError):
        raw = None
    if raw is not None:
        return json.loads(raw)["dato"]
    dato = leer_origen(producto_id)
    entrada = json.dumps({"dato": dato}, ensure_ascii=False)
    try:
        r.set(key, entrada, ex=30 if dato is not None else 5)
    except (redis.ConnectionError, redis.TimeoutError):
        pass  # La respuesta correcta ya procede del origen.
    return dato

if __name__ == "__main__":
    r.delete(clave(42), clave(999))
    print(consultar(42))
    print(consultar(42))
    print(consultar(999))
    print(consultar(999))
    r.close()
La primera consulta de cada identificador imprime “Lectura del origen”; la segunda no. Para el inexistente, la entrada JSON contiene {"dato": null}. Eso es una entrada negativa: durante cinco segundos evita repetir la búsqueda de algo que no existe. Una entrada negativa demasiado larga retrasaría la aparición de un producto recién creado.
El sobre {"dato": ...} diferencia una respuesta válida vacía de la ausencia de la clave. La versión v1 del nombre permite cambiar el contrato a v2 sin que código nuevo intente interpretar entradas antiguas. El ejemplo confía en valores escritos por esta aplicación; en una caché compartida debes validar el esquema y contabilizar entradas inválidas, no dejar que un JSON inesperado tumbe cada petición.
#Actualizar el origen antes de invalidar
Cuando cambia un producto, primero confirma la modificación en su fuente de verdad; después elimina su copia. Si borras antes, otro lector puede recuperar el valor antiguo del origen y volverlo a cachear mientras la actualización sigue pendiente.
# Añadir a cache.py; este origen de demostración es un diccionario.
def cambiar_precio(producto_id, centimos):
    if type(centimos) is not int or centimos < 0:
        raise ValueError("Precio inválido")
    ORIGEN[producto_id]["precio_centimos"] = centimos
    r.delete(clave(producto_id))
En una base relacional, “primero” significa después del commit, la confirmación de la transacción. Si el cambio se revierte, no quieres publicar un estado que nunca existió. Si el commit se confirma y DEL falla, el origen cambió y la caché puede seguir vieja hasta caducar. Registrar y reintentar invalidaciones ayuda; un TTL limita su supervivencia. Las dos escrituras no forman una transacción por estar juntas en Python.
Para cambios importantes, guarda una tarea de invalidación en una tabla de salida (outbox) dentro de la misma transacción del cambio. Otro proceso la entrega con reintentos. Eso conserva la intención de invalidar, pero sigue habiendo un intervalo antes de que se entregue. Si no toleras ese intervalo, lee el origen para esa decisión.
#La carrera que DEL después del commit tampoco elimina
Hay una segunda carrera: un lector puede haber empezado antes del cambio y terminar después de la invalidación. Esta secuencia la reproduce de manera determinista, sin depender de acertar tiempos con hilos. Ejecútala tras importar r, ORIGEN, clave y leer_origen de cache.py:
import json
from cache import r, ORIGEN, clave, leer_origen

key = clave(42)
r.delete(key)
ORIGEN[42]["precio_centimos"] = 3900
copia_lenta = leer_origen(42)               # Lector A empieza.
ORIGEN[42]["precio_centimos"] = 4100        # Escritor B confirma.
r.delete(key)                              # B invalida.
r.set(key, json.dumps({"dato": copia_lenta}), ex=30)  # A termina tarde.
print(ORIGEN[42]["precio_centimos"])        # 4100
print(json.loads(r.get(key))["dato"]["precio_centimos"])  # 3900
Ningún comando individual falló. El problema es el orden entre sistemas. Un TTL de treinta segundos empieza cuando A escribe, no cuando el origen cambió. Si una consulta tarda mucho, la antigüedad total puede superar esos treinta segundos. Por eso también acotas duración de lecturas y defines qué tolerancia estás prometiendo.
#Elegir una mejora según la garantía necesaria
| Necesidad | Diseño razonable | Coste o límite |
|---|---|---|
| Ficha tolerante a pequeños retrasos | Cache-aside + TTL + invalidación tras commit | Puede observar datos antiguos |
| Evitar que lectores viejos repueblen después de invalidar | Generación y escritura condicional con WATCH |
La invalidación aún debe llegar desde el origen |
| Datos inmutables por revisión | Clave que incluye la revisión del origen | Hay que conocer la revisión vigente |
| Decisión que exige el último estado confirmado | Consultar origen transaccional | Renuncias a esa caché en esa decisión |
Una generación es un número o token que cambia al invalidar. El lector recuerda cuál vio y solo publica si no cambió. El capítulo de operaciones compuestas implementa la comprobación; leer y comparar en Python sin proteger la escritura repetiría otra carrera.
La caché debe tener además un presupuesto: tamaño máximo de entrada, caducidad, cardinalidad prevista y métricas. No guardes respuestas arbitrarias de búsqueda con miles de combinaciones sin medir cuántas claves producen. Antes de optimizar, comprueba que tu consulta original tiene índices y límites adecuados: Redis no corrige una consulta mal planteada.