#El objetivo y las decisiones antes de escribir archivos
Vas a construir un catálogo pequeño de libros con tres servicios: un proxy recibe HTTP, una API valida peticiones y PostgreSQL conserva los datos. Puedes leer el catálogo sin credenciales; para añadir libros necesitas un token de escritura. El objetivo no es desarrollar una tienda completa, sino practicar un despliegue donde cada servicio tiene una responsabilidad y un fallo observable.
El proyecto se recorre en tres páginas: construir la API, conectar servicios y operar el conjunto. Cada página organiza sus decisiones por fases. Los archivos completos se despliegan cuando los necesitas; no hay un proyecto descargable que tengas que descifrar. Crea una carpeta local para practicar y escribe allí cada archivo a medida que entiendes su función. Los nombres de archivo indican qué guardar, no una estructura de repositorio que debas instalar.
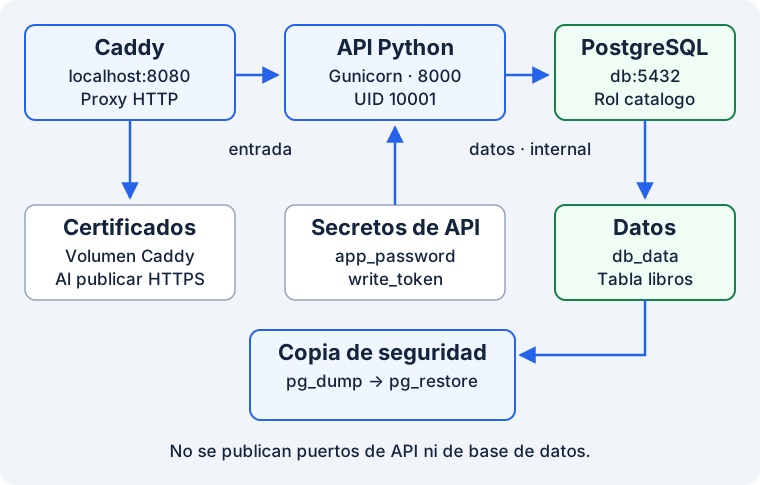
Solo el proxy se publica. La API usa un rol de base limitado; los datos viven en un volumen que sobrevive a su reemplazo.
| Decisión | Por qué la tomamos | Qué sacrificamos conscientemente |
|---|---|---|
| Tres servicios | Separar HTTP público, lógica y persistencia | Más conexiones que un único proceso |
| Lectura pública y escritura con token | Probar autorización sin crear un sistema de usuarios | Un token compartido no ofrece auditoría por persona |
| Una conexión a base por petición | Reconectar automáticamente tras una caída, con código claro | Coste de conexión; para alta carga usarías un pool con límites |
| Dos workers de API | Mostrar concurrencia de procesos con memoria acotada | No es un número universal; debes medirlo |
| Sin cola ni caché | Ninguna operación del catálogo necesita esas piezas | No resuelve informes largos ni búsquedas masivas |
| Un servidor | Poder operar todo con Compose | Si cae el host, debes recuperar el servicio |
La parte HTTP se implementa con WSGI, un contrato Python entre servidor y aplicación. Gunicorn recibe conexiones y llama a una función app(environ, start_response): environ contiene petición y entrada; start_response establece estado y cabeceras; la función devuelve bytes. Psycopg es el cliente que convierte llamadas Python en consultas PostgreSQL. No necesitas aprender un framework web para entender qué papel tiene Docker.
#Fase 1 · Dar a cada secreto un destinatario
Trabaja en una carpeta nueva, por ejemplo catalogo-practica, y ejecuta desde ella:
mkdir -p secrets backups
chmod 700 secrets backups
openssl rand -hex 32 > secrets/db_password
openssl rand -hex 32 > secrets/app_password
openssl rand -hex 32 > secrets/write_token
chmod 644 secrets/db_password secrets/app_password secrets/write_token
db_password es del administrador de PostgreSQL; app_password pertenece al rol limitado de API; write_token autoriza a un cliente a insertar libros. Son identidades distintas. No uses la contraseña de base como token HTTP: los clientes no necesitan administrar ni conectar directamente a la base.
El directorio secrets es privado en el host (700). Sus archivos se montarán individualmente en los servicios autorizados, y deben ser legibles para la API de UID 10001. Aquí son 644 dentro de ese directorio protegido; no saques los archivos a una carpeta pública. En un servidor con política de grupos puedes ajustar propietario/grupo y permisos de forma más restrictiva, comprobando la lectura desde el UID efectivo del contenedor.
Si guardas la práctica en Git, excluye secrets/, backups/ y .env mediante .gitignore. .dockerignore controla la construcción de imágenes, no lo que Git registra.
Guarda un .env con valores no secretos:
COMPOSE_PROJECT_NAME=catalogo-demo
APP_IMAGE=catalogo:1
HTTP_PORT=8080
Ese nombre identifica todos los recursos del laboratorio. Si el puerto ya está ocupado, cambia HTTP_PORT. No reutilices el nombre de un despliegue con datos que quieras conservar.
#Fase 2 · Definir los datos y los permisos
Una fila de libros tendrá un identificador generado por la base y un título. La restricción CHECK impide títulos fuera de longitud incluso si otro cliente se salta la validación Python. La API necesita leer e insertar, pero no borrar tablas ni administrar usuarios.
Guarda init-db.sh:
#!/bin/sh
set -eu
export APP_PASSWORD="$(cat /run/secrets/app_password)"
psql -v ON_ERROR_STOP=1 --username "$POSTGRES_USER" --dbname "$POSTGRES_DB" <<'SQL'
\getenv app_password APP_PASSWORD
CREATE ROLE catalogo LOGIN PASSWORD :'app_password';
REVOKE ALL ON DATABASE catalogo FROM PUBLIC;
REVOKE CREATE ON SCHEMA public FROM PUBLIC;
CREATE TABLE libros (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    titulo text NOT NULL CHECK (length(titulo) BETWEEN 1 AND 120)
);
GRANT CONNECT ON DATABASE catalogo TO catalogo;
GRANT USAGE ON SCHEMA public TO catalogo;
GRANT SELECT, INSERT ON TABLE libros TO catalogo;
GRANT USAGE ON SEQUENCE libros_id_seq TO catalogo;
SQL
unset APP_PASSWORD
El script se ejecuta dentro de la imagen de PostgreSQL. \getenv es una orden de psql que copia una variable de entorno a una variable del cliente; :'app_password' la introduce como literal SQL correctamente escapado. No concatenamos la contraseña dentro de una sentencia a mano.
La tabla y su secuencia pertenecen al administrador. GRANT concede al rol catalogo solo lo necesario. IDENTITY genera identificadores; una secuencia mantiene su contador. ON_ERROR_STOP hace fallar la inicialización si cualquier sentencia falla. Usa chmod +x init-db.sh para marcar el script como ejecutable.
La imagen oficial solo ejecuta /docker-entrypoint-initdb.d/ al inicializar un directorio de datos vacío. Cambiar este script después no migra una base ya existente. Si falla a mitad, un volumen parcialmente inicializado requiere inspección y reparación; en un laboratorio desechable puedes empezar con un volumen nuevo. En producción usarías migraciones versionadas, sin borrar datos para "reintentar".
#Fase 3 · Explicar la API antes de copiarla
La API tiene cuatro rutas:
| Ruta y método | Resultado esperado | Qué comprueba |
|---|---|---|
GET /health/live |
200, proceso vivo |
HTTP y ejecución de Python |
GET /health/ready |
200 o 503 |
Conexión y lectura de la tabla con el rol real |
GET /libros |
Hasta 100 libros | Lectura pública acotada |
POST /libros |
201 con token válido |
Validación, permisos e inserción confirmada |
En cada operación abrimos una conexión con un límite de tres segundos para conectar. statement_timeout=2000 limita una consulta a dos segundos y lock_timeout=1000 limita espera de bloqueos a un segundo. Son valores de este ejercicio, no valores universales. La resolución DNS ocurre antes de la conexión y tiene sus propios tiempos; por eso también configuraremos el resolutor y mantendremos un límite exterior en el proxy. Un timeout de conexión no es automáticamente un plazo total de la petición.
El contexto with connect() as conn de Psycopg confirma la transacción al salir con éxito, o la revierte si hay excepción, y cierra la conexión. Devolvemos 201 después de salir de ese contexto: responder antes de confirmar sería anunciar un éxito que aún podría fallar.
La inserción usa parámetros:
conn.execute(
    'INSERT INTO libros (titulo) VALUES (%s) RETURNING id',
    (title.strip(),),
)
%s es un marcador que interpreta Psycopg; el valor se envía por separado. La coma en (valor,) construye una tupla de un elemento. No uses una f-string para meter texto del usuario dentro del SQL. RETURNING devuelve el identificador que generó la base, sin adivinar el siguiente número.
Guarda ahora app.py. El archivo completo incluye validación de JSON, longitud y token; los errores de base devuelven 503 y registran el tipo de error, no credenciales.
Ver app.py completo · API, validación y transacciones
import hmac
import json
import os
from pathlib import Path

import psycopg

PASSWORD = Path(os.environ['DB_PASSWORD_FILE']).read_text().strip()
WRITE_TOKEN = Path(os.environ['WRITE_TOKEN_FILE']).read_text().strip()
if not PASSWORD or not WRITE_TOKEN:
    raise RuntimeError('Falta un secreto necesario')


def connect():
    return psycopg.connect(
        host=os.environ['DB_HOST'],
        dbname=os.environ['DB_NAME'],
        user=os.environ['DB_USER'],
        password=PASSWORD,
        connect_timeout=3,
        options='-c statement_timeout=2000 -c lock_timeout=1000',
    )


def reply(start_response, status, payload):
    body = json.dumps(payload, ensure_ascii=False).encode('utf-8')
    start_response(status, [
        ('Content-Type', 'application/json; charset=utf-8'),
        ('Content-Length', str(len(body))),
        ('Cache-Control', 'no-store'),
    ])
    return [body]


def app(environ, start_response):
    path = environ.get('PATH_INFO', '/')
    method = environ['REQUEST_METHOD']
    try:
        if method == 'GET' and path == '/health/live':
            return reply(start_response, '200 OK', {'alive': True})

        if method == 'GET' and path == '/health/ready':
            with connect() as conn:
                conn.execute('SELECT id FROM libros LIMIT 1').fetchall()
            return reply(start_response, '200 OK', {'ready': True})

        if method == 'GET' and path == '/libros':
            with connect() as conn:
                rows = conn.execute(
                    'SELECT id, titulo FROM libros ORDER BY id DESC LIMIT 100'
                ).fetchall()
            return reply(start_response, '200 OK', {
                'libros': [{'id': row[0], 'titulo': row[1]} for row in rows]
            })

        if method == 'POST' and path == '/libros':
            supplied = environ.get('HTTP_AUTHORIZATION', '')
            expected = 'Bearer ' + WRITE_TOKEN
            if not hmac.compare_digest(supplied.encode(), expected.encode()):
                return reply(start_response, '401 Unauthorized', {'error': 'token requerido'})
            content_type = environ.get('CONTENT_TYPE', '').split(';')[0].strip().lower()
            if content_type != 'application/json':
                return reply(start_response, '415 Unsupported Media Type', {'error': 'usa JSON'})
            try:
                length = int(environ.get('CONTENT_LENGTH') or '0')
            except ValueError:
                return reply(start_response, '400 Bad Request', {'error': 'longitud inválida'})
            if not 0 < length <= 4096:
                return reply(start_response, '413 Payload Too Large', {'error': 'cuerpo de 1 a 4096 bytes'})
            try:
                payload = json.loads(environ['wsgi.input'].read(length))
            except (ValueError, UnicodeDecodeError):
                return reply(start_response, '400 Bad Request', {'error': 'JSON inválido'})
            title = payload.get('titulo') if isinstance(payload, dict) else None
            if not isinstance(title, str) or not 1 <= len(title.strip()) <= 120:
                return reply(start_response, '400 Bad Request', {'error': 'titulo de 1 a 120 caracteres'})
            with connect() as conn:
                book_id = conn.execute(
                    'INSERT INTO libros (titulo) VALUES (%s) RETURNING id',
                    (title.strip(),),
                ).fetchone()[0]
            return reply(start_response, '201 Created', {'id': book_id, 'titulo': title.strip()})

        return reply(start_response, '404 Not Found', {'error': 'ruta o método no disponibles'})
    except psycopg.Error as error:
        print(json.dumps({'event': 'database_error', 'type': type(error).__name__}), flush=True)
        return reply(start_response, '503 Service Unavailable', {'error': 'base no disponible'})
hmac.compare_digest compara el token evitando una comparación normal que pueda filtrar información por tiempos; es una función de la biblioteca estándar. Comparamos bytes para admitir de forma controlada cabeceras con caracteres inesperados. Path lee los secretos al arrancar: si los rotas, recrea los workers después de coordinar el cambio en la base.
La lista se limita a 100 filas para no convertir cada petición en una descarga ilimitada. Para un catálogo mayor añadirías paginación con cursor y un contrato de orden estable. Un timeout de escritura tiene resultado potencialmente ambiguo: la base podría haber confirmado y la respuesta haberse perdido. No reintentes POST ciegamente; para un cliente con reintentos añadirías una clave de idempotencia almacenada con el resultado.
#Fase 4 · Construir el entorno de la API
Guarda requirements.txt:
gunicorn==26.2.0
psycopg[binary]==3.3.6
Son versiones concretas comprobadas para este ejemplo. psycopg[binary] selecciona el extra que incluye componentes binarios preparados, evitando instalar un compilador y bibliotecas de desarrollo para esta práctica. Cuando actualices dependencias, prueba el conjunto antes de cambiar la versión desplegada; conserva también las dependencias transitivas resueltas si tu proceso exige reproducción exacta.
Guarda Dockerfile:
Ver Dockerfile completo · construcción y ejecución
FROM python:3.13-slim AS dependencias
WORKDIR /build
RUN python -m venv /opt/venv
COPY requirements.txt ./
RUN /opt/venv/bin/pip install --no-cache-dir -r requirements.txt

FROM python:3.13-slim AS ejecucion
ENV PATH="/opt/venv/bin:$PATH" \
    PYTHONUNBUFFERED=1 \
    PYTHONDONTWRITEBYTECODE=1
WORKDIR /app
RUN groupadd --gid 10001 app \
    && useradd --uid 10001 --gid app --no-create-home app
COPY --from=dependencias /opt/venv /opt/venv
COPY app.py ./
USER 10001:10001
EXPOSE 8000
CMD ["gunicorn", "app:app", "--bind", "0.0.0.0:8000", "--workers", "2", "--no-control-socket", "--timeout", "10", "--graceful-timeout", "15", "--access-logfile", "-", "--error-logfile", "-"]
La primera etapa instala dependencias en /opt/venv; la segunda copia ese entorno y el código. La misma familia de Python y base en ambas reduce incompatibilidades. El código queda legible, pero la API se ejecuta como UID 10001. app:app significa "importa el módulo app.py y usa su función app".
Gunicorn mantiene dos workers y escribe logs en las salidas del contenedor. --no-control-socket desactiva su interfaz administrativa local, que este proyecto no usa; así no intenta crear un socket en el directorio personal del usuario cuando el sistema de archivos es de solo lectura. Su timeout detecta workers que no responden; no debe confundirse con un timeout de cada consulta ni con la política de un cliente HTTP. El apagado deja hasta quince segundos a Gunicorn y treinta al contenedor para terminar de forma ordenada.
Guarda .dockerignore, para que los secretos y copias ni siquiera formen parte del contexto:
.git
.venv
__pycache__
*.pyc
.env
secrets/
backups/
#Punto de control antes de conectar servicios
Ya tienes un contrato de datos y permisos, una API con tiempos de espera y una imagen que puedes reconstruir. En la siguiente página añadirás Caddy y Compose, y comprobarás lectura, escritura autorizada y rechazo por falta de permisos. No necesitas arrancar archivos sueltos todavía: la configuración de conexión llega en ese paso.
#Fuentes de esta parte
- Uso básico de Psycopg: conexión, transacción y cierre.
- Parámetros SQL: separar valores del texto SQL.
- Contrato WSGI: la interfaz que usa Gunicorn para ejecutar la función.
- Inicialización PostgreSQL: alcance de los scripts iniciales.